 Cao Note
ElasticSearch
配套知识点:Elasticsearch
怎么用这份笔记
- 分级:
★★★ 必须吃透/★★☆ 了解即可(记结论就行)/★☆☆ 可以跳过(一句话看一眼)- 标了【简历亮点】的,面试官会顺着简历往下挖,要能展开讲两分钟
- 文末是折叠的原始题库,查漏补缺时再展开
1. ES 是什么,和 Lucene、MySQL 什么关系 ★★☆
- Lucene:Java 写的单机搜索库,倒排索引 + 打分都在它里面。
- ElasticSearch:基于 Lucene 的分布式搜索引擎,补上了分片、副本、REST API、聚合、集群管理。
- 和 MySQL 的关系:ES 不是数据库,没有事务、没有强一致、不擅长更新。它的定位是检索和聚合,业务数据仍在 MySQL,ES 是它的「搜索副本」。
概念对应(面试常拿来类比):
| MySQL | ElasticSearch |
|---|---|
| Database | Index(索引) |
| Table | ——(7.x 起去掉了 Type,一个索引一种文档) |
| Row | Document |
| Column | Field(mapping 定义类型) |
| Schema | Mapping |
2. 倒排索引与分词 ★★★
正排 vs 倒排:
- 正排:文档 id → 文档内容,找「包含某词的文档」只能全表扫。
- 倒排:词 → 文档 id 列表(还有词频、位置),一次定位。
文档 1:Java 集合 HashMap
文档 2:Java 并发 AQS

倒排索引
java   → [1, 2]
集合   → [1]
hashmap→ [1]
并发   → [2]
aqs    → [2]
文档 1:Java 集合 HashMap
文档 2:Java 并发 AQS
倒排索引
java → [1, 2]
集合 → [1]
hashmap→ [1]
并发 → [2]
aqs → [2]分词(Analyzer) 三步:char filter(字符过滤,如去 HTML 标签)→ tokenizer(切词)→ token filter(小写化、去停用词、同义词)。
中文分词是重点:
| 分词器 | 特点 |
|---|---|
standard | 按字切,中文会拆成单字,召回高但精度差 |
ik_max_word | 最细粒度切分,「南京市长江大桥」全切出来,召回高、索引大 |
ik_smart | 最粗粒度,歧义少,精度高 |
pinyin | 拼音检索(搜索建议场景) |
实践口径:索引时用 ik_max_word(尽量多切,提高召回),查询时用 ik_smart(少切,提高精度)—— 通过 search_analyzer 单独指定。
3. Mapping:text 与 keyword ★★★
这是 ES 最高频的坑。
| 类型 | 是否分词 | 用途 |
|---|---|---|
text | 分词 | 全文检索(标题、正文) |
keyword | 不分词、整体索引 | 精确匹配、聚合、排序(订单号、状态、标签) |
{
  "mappings": {
    "properties": {
      "title":   { "type": "text", "analyzer": "ik_max_word", "fields": { "raw": { "type": "keyword" } } },
      "orderNo": { "type": "keyword" },
      "amount":  { "type": "scaled_float", "scaling_factor": 100 },
      "createdAt": { "type": "date" }
    }
  }
}
{
"mappings": {
"properties": {
"title": { "type": "text", "analyzer": "ik_max_word", "fields": { "raw": { "type": "keyword" } } },
"orderNo": { "type": "keyword" },
"amount": { "type": "scaled_float", "scaling_factor": 100 },
"createdAt": { "type": "date" }
}
}
}要点:
text不能用来排序和聚合(除非用.keyword子字段),这是「为什么我的聚合报 fielddata 错误」的根因。- mapping 一旦建好,字段类型不能改,只能 reindex。所以设计阶段就要定好。
- 两个原则:只给需要检索的字段建索引(
index: false),只存需要返回的字段(_source里 filter 掉大字段)。
4. 写入流程:refresh / translog / flush / merge ★★★
写请求 → 内存 buffer + translog(追加日志)
   │
   ├─ 每秒 refresh ──→ 生成新的 segment(写入文件系统缓存)→ 此时才「可被搜索」
   │
   ├─ translog 满 / 30 分钟 ──→ flush:fsync segment 落盘 + 清空 translog
   │
   └─ segment 变多 ──→ merge:合并小段、真正删除标记删除的文档
写请求 → 内存 buffer + translog(追加日志)
│
├─ 每秒 refresh ──→ 生成新的 segment(写入文件系统缓存)→ 此时才「可被搜索」
│
├─ translog 满 / 30 分钟 ──→ flush:fsync segment 落盘 + 清空 translog
│
└─ segment 变多 ──→ merge:合并小段、真正删除标记删除的文档四个概念一定要分清:
| 概念 | 触发 | 作用 |
|---|---|---|
| refresh | 默认 1 秒 | buffer → segment,让数据可搜索(不落盘、不持久) |
| flush | translog 阈值 / 定时 | segment 落盘 + 清空 translog(真正持久化) |
| merge | 后台自动 / force_merge | 合并小段,物理删除已标删的文档 |
| translog | 每次写 | 保证 refresh 前宕机不丢数据(类似 MySQL redo log) |
面试延伸:refresh_interval: -1 + number_of_replicas: 0 是批量导入的标准做法(关掉刷新、关掉副本),导完再改回来。
5. 查询流程:两阶段 + query vs filter ★★★
查询分两个阶段:
- Query 阶段(scatter):请求打到某个协调节点,它把查询广播到每个分片,各分片返回
from + size条 docId + 分数。 - Fetch 阶段(gather):协调节点归并排序,取前 N 个 docId,再回对应分片取
_source。
所以分片越多,协调节点归并越慢,这也是深分页的根因之一。
query 与 filter 的区别(必问):
| query context | filter context | |
|---|---|---|
| 打分 | 算 _score | 不算分 |
| 缓存 | 不缓存 | 结果可缓存(bitset) |
| 用途 | 相关性排序 | 精确筛选(状态、时间范围、id) |
{
  "query": {
    "bool": {
      "must":   [ { "match": { "title": "并发" } } ],
      "filter": [ { "term": { "status": "ONLINE" } },
                  { "range": { "createdAt": { "gte": "now-7d" } } } ]
    }
  }
}
{
"query": {
"bool": {
"must": [ { "match": { "title": "并发" } } ],
"filter": [ { "term": { "status": "ONLINE" } },
{ "range": { "createdAt": { "gte": "now-7d" } } } ]
}
}
}口径:只需要筛选不需要打分的条件,一律放
filter,能吃缓存还省打分开销。
6. 深分页问题与三种解法 ★★★
from + size 会随着页数变大而急剧变慢:每翻一页,每个分片都要返回 from + size 条,协调节点再归并。默认 index.max_result_window = 10000 就是这个原因。
| 方案 | 原理 | 限制 |
|---|---|---|
from + size | 跳页 | 超过 10000 报错 |
scroll | 生成快照游标,分批取 | 有快照内存开销、不能跳页、不适合实时 |
search_after | 用上一页最后一条的排序值继续取 | 不能跳页,但实时、开销小,首选 |
{ "size": 20, "sort": [ { "createdAt": "asc" }, { "_id": "asc" } ],
  "search_after": [ "2026-10-01T10:00:00", "abc123" ] }
{ "size": 20, "sort": [ { "createdAt": "asc" }, { "_id": "asc" } ],
"search_after": [ "2026-10-01T10:00:00", "abc123" ] }注意 sort 里必须带唯一 tiebreaker(比如 _id),否则同一时间戳的记录会漏或重。
如果是给用户做的后台分页(必须能跳页),工程上更常见的是「限制最大页数 + 结果缓存到 Redis」,或者干脆换 ClickHouse。
7. 集群:分片、副本、选主与脑裂 ★★★
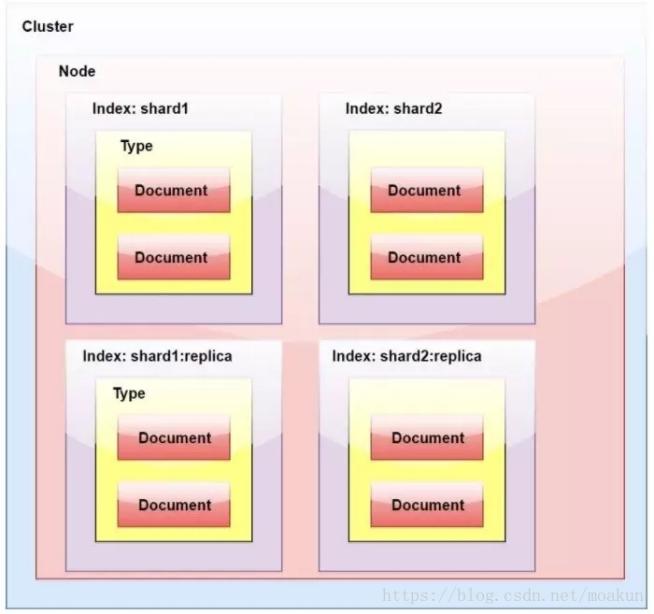
- 分片(shard):索引的水平切分,建索引时定死,不能改(除非 reindex / shrink / split)。一个分片就是一个 Lucene 实例。
- 副本(replica):分片的拷贝,提供读扩展 + 故障转移;副本数可以随时改。
- 写只能写主分片,再由主分片同步给副本(所以写性能受副本数影响)。
选主(7.x 之后是 7.0 引入的「基于投票的类 Raft 算法」,不再是 Zen Discovery):
- 只有
node.master: true的候选节点能被选为 master; - 需要超过半数的候选节点投票(
discovery.seed_hosts+cluster.initial_master_nodes); - 脑裂的根因是网络分区,现在靠「多数派投票」天然避免,前提是候选节点数配成奇数(3 个集群可容忍挂 1 个)。
分片怎么设计(这是运维题):
- 单分片建议 10~50GB,别超过 50GB(merge 和恢复会非常慢);
- 分片数 ≈ 数据总量 / 30GB,再按节点数取整;
- 分片不是越多越好:每个分片都有独立开销,小索引用 1 个分片就够(几百个小分片会拖垮集群)。
8. ES 与 MySQL 数据同步 ★★★ 【简历亮点】
写 ES 的三种方式,面试一定要能说出取舍:
| 方案 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 同步双写 | 业务代码里写完 MySQL 再写 ES | 实时 | 耦合、失败要补偿、接口 RT 变长 |
| 异步双写(MQ) | 写完 MySQL 发消息,消费者写 ES | 解耦、可重试 | 有延迟、要处理幂等与顺序 |
| Canal 订阅 binlog | 伪装成 MySQL 从库,解析 binlog 投递 | 业务零侵入、可靠 | 运维成本高、要处理表结构变更 |
推荐口径:Canal + MQ + 幂等消费。三个必须补的点:
- 全量 + 增量:上线时先全量刷一遍(用
_bulk),再切到 binlog 增量; - 幂等:以业务主键做
_id,用index而不是create,重复消费不会产生重复文档; - 顺序:同一订单的更新必须按顺序消费,否则旧值覆盖新值 —— 用「同一路由 key 打到同一分区」保证。
9. 性能优化:写入 / 查询 / 设计三段 ★★★
写入优化
_bulk批量提交,每批 5~15MB(别超过 100MB,会 OOM);- 导入期间
refresh_interval: -1、number_of_replicas: 0; - 用自动生成的 id(自定义 id 每次都要查一次是否已存在);
- 控制
_source(不存无用字段),必要时store: false。
查询优化
- 只查需要的字段:
_source: ["id","title"],别SELECT *; - 筛选放
filter,利用 bitset 缓存; - 禁用
wildcard前缀模糊(*abc必然全扫),改用ngram分词或keyword前缀查询; terms里塞几百个值会爆内存,分批查;- 聚合字段超过阈值要
eager_global_ordinals。
设计阶段
- 时间序列数据用 rollover + 别名,按天/周建索引,避免单索引无限膨胀;
- 冷热分离:热数据 SSD 少副本、冷数据大副本 +
force_merge+shrink; - 用
_ilm(生命周期管理)自动 rollover / 删除。
10. ES 做向量检索:和 RAG 的关系 ★★☆
7.3 起 ES 支持 dense_vector,8.x 支持 kNN 查询(HNSW 索引),所以「已有 ES 就不要另起一套向量库」是常见选型。
"mappings": { "properties": { "embedding": {
"type": "dense_vector", "dims": 1024, "index": true, "similarity": "cosine" } } }"mappings": { "properties": { "embedding": {
"type": "dense_vector", "dims": 1024, "index": true, "similarity": "cosine" } } }"knn": { "field": "embedding", "query_vector": [0.12, -0.3, ...], "k": 10, "num_candidates": 100 }"knn": { "field": "embedding", "query_vector": [0.12, -0.3, ...], "k": 10, "num_candidates": 100 }实践要点:
- ES 的强项是 BM25 关键词 + kNN 向量混合检索,再把两路结果做 RRF 融合 —— 比纯向量召回准得多;
- 千万级以上向量、极致低延迟,仍然选 Milvus / Qdrant;百万级以内、已有 ES 集群,ES 的性价比最高;
- 向量维度越高内存占用越大(1024 维 float = 4KB/条),10 万条就要 400MB,要算清楚。
11. 数据量大了怎么办 ★★☆
| 阶段 | 手段 |
|---|---|
| 预防 | 建索引前规划好分片数、按时间滚动索引、别名管理 |
| 增长中 | 加节点(分片可以自动均衡)、扩副本、冷热分层 |
| 已经爆了 | reindex 到新索引(更少分片)、force_merge 清碎片、删除历史数据、归档到对象存储 |
| 极限 | 只保留近 N 天在 ES,全量数据留在 Hive/ClickHouse 做分析 |
附:原始题库(旧版逐题,与上文重叠,可折叠跳过)
展开查看原始题库
1. 谈谈分词与倒排索引的原理
首先说分词是给检索用的。
英文:一个单词一个词,很简单。I am a student,词与词之间空格分隔。
中文:我是学生,就不能一个字一个字地分,我-是-学生。这是好分的。还有歧义的,使用户放心,使用-户,使-用户。人很容易看出,机器就难多了。所以市面上有各种各样的分词器,一个强调的效率一个强调的准确率。
倒排索引:倒排针对的是正排。
- 正排就是我记得我电脑有个文档,讲了 ES 的常见问题总结。那么我就找到文档,从上往下翻页,找到 ES 的部分。通过文档找文档内容。
- 倒排:一个 txt 文件 ES 的常见问题 -> D:/分布式问题总结.doc。
所以倒排就是文档内容找文档。当然内容不是全部的,否则也不需要找文档了,内容就是几个分词而已。这里的 txt 就是搜索引擎。
2. 说说分段存储的思想
Lucene 是著名的搜索开源软件,ElasticSearch 和 Solr 底层用的都是它。
分段存储是 Lucene 的思想。
早期,都是一个整个文档建立一个大的倒排索引。简单,快速,但是问题随之而来。
文档有个很小的改动,整个索引需要重新建立,速度慢,成本高,为了提高速度,定期更新那么时效性就差。
现在一个索引文件,拆分为多个子文件,每个子文件是段。修改的数据不影响的段不必做处理。
3. 谈谈你对段合并的策略思想的认识
分段的思想大大的提高了维护索引的效率。但是随之就有了新的问题。
每次新增数据就会新增加一个段,时间久了,一个文档对应的段非常多。段多了,也就影响检索性能了。
检索过程:
- 查询所有段中满足条件的数据
- 对每个段的结果集合并
所以,定期的对段进行合理合并是很必要的。真是天下大势,分久必合合久必分。
策略:将段按大小排列分组,大到一定程度的不参与合并。小的组内合并。整体维持在一个合理的大小范围。当然这个大到底应该是多少,是用户可配置的。这也符合设计的思想。
4. 了解文本相似度 TF-IDF 吗
简单地说,就是你检索一个词,匹配出来的文章、网页太多了。比如 1000 个,这些内容再该怎么呈现,哪些在前面哪些在后面。这需要有个对匹配度的评分。
TF-IDF 就是干这个的。
TF = Term Frequency 词频,一个词在这个文档中出现的频率。值越大,说明这文档越匹配,正向指标。
IDF = Inverse Document Frequency 反向文档频率,简单点说就是一个词在所有文档中都出现,那么这个词不重要。比如「的、了、我、好」这些词所有文档都出现,对检索毫无帮助。反向指标。
TF-IDF = TF × IDF(原文写作 TF / IDF,实际是相乘)。
复杂的公式就不写了,主要理解他的思想即可。(7.x 之后默认打分函数已换成 BM25,比 TF-IDF 多了「词频饱和」和「文档长度归一化」。)
5. 能说说 ElasticSearch 写索引的逻辑吗?
ElasticSearch 是集群的 = 主分片 + 副本分片。
写索引只能写主分片,然后主分片同步到副本分片上。但主分片不是固定的,可能网络原因,之前还是 Node1 是主分片,后来就变成了 Node2 经过选举成了主分片。
客户端如何知道哪个是主分片呢?看下面过程。
- 客户端向某个节点 NodeX 发送写请求
- NodeX 通过文档信息,请求会转发到主分片的节点上
- 主分片处理完,通知到副本分片同步数据,向 NodeX 发送成功信息
- NodeX 将处理结果返回给客户端
6. 熟悉 ElasticSearch 集群中搜索数据的过程吗?
- 客户端向集群发送请求,集群随机选择一个 NodeX 处理这次请求。
- NodeX 先计算文档在哪个主分片上,比如是主分片 A,它有三个副本 A1、A2、A3。那么请求会轮询三个副本中的一个完成请求。
- 如果无法确认分片,比如检索的不是一个文档,就遍历所有分片。
补充一点,一个节点的存储量是有限的,于是有了分片的概念。但是分片可能有丢失,于是有了副本的概念。
比如:ES 集群有 3 个分片 A、B、C,那么 A + B + C = 所有数据,每个分片只有大概 1/3。分片 A 又有副本 A1、A2、A3,数据都是一样的。
7. 了解 ElasticSearch 深翻页的问题及解决吗?
深翻页:比如我们检索一次,轮询所有分片,汇集结果,根据打分排序后将前 10 条数据返回。用户感觉不错,说看看下一页。ES 依然是轮询所有分片,汇集结果,打分排序后将前 11-20 条返回。
对用户来说,翻页应该很快啊,但是实际上,第一次检索多复杂,下一次检索就多复杂。
解决的话,可以把用户的检索结果存入 Redis 中 10 分钟。这样分页就很快,超过 10 分钟用户不翻页,也就不会翻页了,数据就可以清除了。
8. 熟悉 ElasticSearch 性能优化
- 批量提交:大量写操作时,每次提交都是一次网络开销。
- 优化硬盘:索引文件需要落地硬盘,段的思想又带来了更多小文件,磁盘 IO 是 ES 的性能瓶颈。
- 减少副本数量:副本保证可用性但严重影响写索引效率,批量导入建议关闭副本。
补充:Elasticsearch 是一个基于 Lucene 的搜索引擎,提供分布式、多租户能力的全文搜索,RESTful 接口,用 Java 开发。
9. ElasticSearch 查询优化手段有哪些?
设计阶段调优:按日期模板 + rollover 滚动索引、别名管理、定时 force_merge、冷热分离、curator 生命周期管理、只对需要分词的字段设分词器、mapping 阶段明确是否检索/是否存储。
写入调优:写入前副本数设 0、refresh_interval 设 -1、bulk 批量写、写完恢复、尽量用自动生成的 id。
查询调优:禁用 wildcard、禁用大批量 terms、能用 keyword 就用 keyword、大数据量先按时间锁定索引、设置合理路由。
10. ElasticSearch 是如何实现 master 选举的?
前置前提:
- 只有候选主节点(
node.master: true)才能成为主节点。 - 最小主节点数(
discovery.zen.minimum_master_nodes/ 7.x+ 的cluster.initial_master_nodes)用于防止脑裂。
选举流程(Zen Discovery 时代):确认候选节点数达标 → 比较是否具备 master 资格 → 资格相同时 id(字符串)小的当选。
查节点 id:
GET /_cat/nodes?v&h=ip,port,heapPercent,heapMax,id,nameGET /_cat/nodes?v&h=ip,port,heapPercent,heapMax,id,name注:7.0 之后已改为基于投票的类 Raft 算法,不再用
minimum_master_nodes。
11. ElasticSearch 索引数据多了怎么办,如何调优,部署?
规划先行:动态索引层面用「模板 + 时间 + rollover」滚动建索引,避免单索引膨胀到 TB 级;存储层面做冷热分离,冷数据 force_merge + shrink;部署层面可动态加节点,前提是主节点规划合理,无需重启集群。
12. 说说你们公司 ES 的集群架构、索引数据大小、分片有多少?
如实结合自己的实践回答即可。参考口径:13 节点集群,按业务通道 20+ 索引,按日递增,每索引 10 分片,每日 1 亿+ 文档,单日索引 150GB 以内。
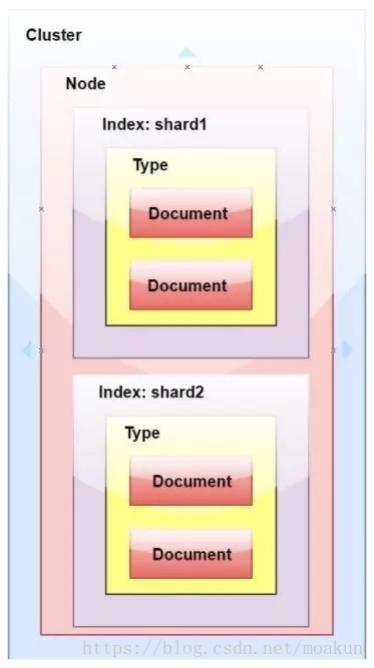
13. ElasticSearch 中的集群、节点、索引、文档、类型是什么?
- 集群:一个或多个节点的集合,共同保存数据并提供联合索引与搜索,用唯一集群名标识。
- 节点:集群中的单个服务器实例,存储数据并参与索引与搜索。
- 索引:类似关系库的「数据库」,是逻辑命名空间,映射到一个或多个主分片,可有零个或多个副本。
- 文档:类似一行记录,JSON 结构,同一索引内字段可以不同但通用字段类型应一致。
- 类型:7.x 已移除(一个索引只有一种文档结构)。
14. ElasticSearch 中的分片是什么?
索引是文档的集合;分片是因为分布式而把索引切分到多个节点上的元素;副本是分片的拷贝。一个节点是集群中的一个 ES 运行实例。
补充:索引时数据由 Analyzer 处理,Analyzer = 一个 Tokenizer + 零个或多个 TokenFilter,前面还可以有 CharFilter。ES 内置大量分析器,也可组合自定义。
15. 启用属性、索引和存储的用途是什么?
enabled:是否对该字段建立索引结构(false时只存不索引)。index:是否可被搜索。只有被索引的字段才能搜索。store:是否独立存储原始值(默认不存,靠_source返回完整原文)。
因为分析阶段已对字段做了转换,所以需要原始值时通常直接用 _source,不必开 store。
附:一句话速记(可以跳过 ★☆☆)
- 倒排索引:词 → 文档列表;写入先分词再建词典。
- refresh / flush / merge:refresh 让数据「可搜」,flush 才「落盘」,merge 真正「删物理文件」。
- text 与 keyword:分词的用
text,排序聚合精确匹配用keyword。 - 深分页:
from+size有 10000 上限,用search_after(带唯一 tiebreaker)。 - query vs filter:要打分用 query,只筛选用 filter(能走缓存)。
- 写只能写主分片,副本数影响写性能;分片数建索引后改不了。
- 同步:Canal 订阅 binlog + MQ + 幂等(业务主键当
_id)。 - 向量检索:ES 8.x 支持 kNN,BM25 + kNN 混合 + RRF 融合效果好。