 Cao Note
异常、IO 与反射
配套知识点:02 Java 核心特性
怎么用这份笔记
- 分级:
★★★ 必须吃透/★★☆ 了解即可(记结论就行)/★☆☆ 可以跳过(一句话看一眼)- 【简历亮点,高频追问】:简历里写过的技术,面试官会顺着往下挖,这段必须能展开讲
- 每个考点按「定义 → 原理 → 要点 / 易错点」组织,只讲知识点
1. 反射 ★★★
反射是运行时获取类的结构(构造器、字段、方法、注解)并调用它,绕开编译期的类型检查。这是框架的基础:Spring 建 Bean、MyBatis 做结果映射都依赖它。
- 代价有两个:慢,因为要动态解析并做安全检查;以及破坏封装,能拿到私有成员。
- 工程上的优化:启动阶段一次性完成反射并缓存结果,运行期不做反射;
setAccessible(true)关闭安全检查能提升速度;需要高频创建实例时可用 ReflectASM 这类字节码生成方案。 - 插件化是典型用法:给各厂商的命令实现类加自定义注解,启动时按包扫描把所有带注解的类扫出来,反射实例化后按「协议类型 + 命令字」注册进命令表。这样新增一条指令只要写一个带注解的类,不必改动核心链路。
2. 注解与自定义注解 ★★★ 【简历亮点,高频追问】
注解是贴在类、方法、字段上的标签,本身不改变逻辑,必须由外部读取才生效:运行期靠反射读,编译期靠注解处理器读(Lombok 就是后者)。
@Retention决定注解保留到哪一步,只有 RUNTIME 的才能在运行期通过反射拿到;@Target限定它可以标注的位置。两者是自定义注解的固定搭配。- 注解 + 切面(AOP) 是最常见的落地方式:横切逻辑集中在切面里,业务代码只加一行注解,新增功能不用改业务代码。典型用途:协议命令行按注解自动注册、
@RepeatSubmit防重复提交、基于注解的限流、统一鉴权。
3. 异常体系 / try-with-resources ★★★
根是 Throwable,下面分两支:
- Error:JVM 级故障,比如 OOM,程序本身修不了,不捕获。
- Exception,又分受检与非受检:
- 受检异常:编译期强制处理,要么
throws声明,要么try-catch捕获,否则编译不通过,如 IOException;通常是调用方能预判、能恢复的情况。 - 非受检异常(RuntimeException 及子类):编译器不检查,如 NPE;一般是编程错误,应该改代码而不是到处捕获。
- 受检异常:编译期强制处理,要么
另外两个要点:
- finally 一定执行,除非执行了
System.exit。 - try-with-resources 可以自动关闭资源,比在 finally 里手写关闭更安全。
自定义异常统一继承 RuntimeException,避免 throws 沿全链路污染。捕获的位置放在系统边界:Controller、消息消费者(如 Kafka)、定时任务,统一记日志并转成友好响应。设备报文场景下,单个报文解析失败只丢弃这一条,不能让整条连接挂掉,所以每条报文的处理入口都要单独做异常兜底。
4. 什么时候抛、什么时候捕获 / throw vs throws ★★☆
- 能处理就捕获:能重试、能降级、能记日志补偿的,在本地处理掉,比如下游调用失败后重试 + 降级返回。
- 处理不了就往上抛:或者调用方需要知道结果的情况(参数校验失败、设备不存在这类),直接抛业务异常,由上层统一转成响应。
- throw 与 throws:
throw是抛出一个异常对象(动作),throws是声明方法可能抛出什么(方法签名)。 - 原则:不吞异常,也不拿异常当流程控制;
catch里不能直接catch (Exception)然后返回 null,至少要打日志,否则问题无从排查。
5. final / finally(finalize 已废弃)★★☆
final / finally / finalize 三者只是拼写相近,没有语义关系:
- final:修饰类 → 不能被继承;修饰方法 → 不能被重写;修饰变量 → 引用不能改(对象内部内容仍可变)。
- finally:异常处理中一定会执行的那段代码(除非
System.exit),通常用来释放资源。 - finalize:对象被回收前调用的方法,JDK 9 起已废弃。它执行时机不确定、可能延迟 GC,还能让对象复活,不要用它释放资源;释放资源应该用 try-with-resources 或 Cleaner。
工程用法:工具类、常量类用 final 修饰,防止被继承破坏;处理器基类被各厂商子类继承时,把基类里的编解码主流程声明为 final,只开放子类实现业务方法,保证流程一致、不被改坏。
6. 字节码 / JDK-JRE-JVM ★★★
- 字节码:源码用
javac编译成 字节码(.class),由 JVM 负责执行。字节码与平台无关,各平台 JVM 负责翻译执行,所以是「一次编译,到处运行」。 - JIT:运行期把热点字节码编译成本地机器码,这是 Java 性能的关键。
- 包含关系:JDK ⊃ JRE ⊃ JVM。JVM 负责跑;JRE = JVM + 核心类库;JDK 在 JRE 之上再加编译器等开发工具。
部署上常见多阶段构建:构建阶段用 JDK(例如 JDK 21 编译),运行镜像只放 JRE,以此减小镜像体积。上层能力(AOP 代理、协议插件的动态注册)都建立在字节码这一层之上。
7. BIO / NIO / AIO ★★★ 【简历亮点,高频追问】
- BIO:一连接一线程,读写都阻塞,线程数随连接数线性增长,扛不住高并发。
- NIO:同步非阻塞 + 多路复用,一个线程用 Selector 管理大量连接,谁有事件就处理谁;底层依赖 Linux 的 epoll。
- AIO:异步,读写完成后由内核回调通知;但 Linux 上实现不成熟(本质仍是 epoll 模拟),跨平台一致性不如 NIO。
NIO 的三大件:Buffer(缓冲区)、Channel(双向通道)、Selector(多路复用器)。
选型依据:
- 设备长连接场景(大量 TCP 连接常驻)选 Netty,本质是 NIO 封装:设备量上去以后 BIO 的一连接一线程撑不住;AIO 在 Linux 上不成熟,所以不用。
- Netty 的 ChannelHandler 链路能把编解码、心跳、鉴权拆成独立 handler,职责清晰、便于组合复用。
8. Optional / Java 8 新特性 ★★★
- Optional 是包装「可能为空的值」的容器,把「可能没值」这件事在方法签名上显式表达出来。
orElse无论有没有值都会计算参数,orElseGet才是惰性求值;兜底逻辑有开销时必须用orElseGet。- 使用范围:只建议当方法返回值(例如单对象查询这类可能查不到的场景),不当字段、不当参数,否则只会增加复杂度。
- 同批的 Java 8 新特性:Stream、新时间 API(
LocalDateTime等)、CompletableFuture 是最常用的三块。
9. 深拷贝浅拷贝 / serialVersionUID ★★☆
- 浅拷贝:只复制对象本身,内部的引用字段仍指向同一个对象,两个对象共享引用。
- 深拷贝:把引用链上的对象全部复制一份,彼此完全独立。
clone()默认是浅拷贝;要深拷贝可以覆写clone逐层复制,或者直接用序列化 / 反序列化做拷贝。
serialVersionUID 是序列化版本号:
- 不显式声明时由编译器按类结构生成,类一改动(加字段、改方法)值就会变,旧数据反序列化失败。
- 跨服务传输的 DTO 应显式声明
serialVersionUID,避免加个字段就造成反序列化不兼容。 - 需要对象快照又不想手写
clone时,可以直接用序列化拷贝实现深拷贝。
10. Collection 与 Collections 的区别 ★★☆
一句话:Collection 是接口,Collections 是工具类(多一个 s)。
- Collection:
List/Set/Queue的父接口,定义集合的基本能力——add、remove、size、iterator。 - Collections:全是静态方法的工具类,用来操作或包装集合:
sort、reverse、shuffle、max/min、binarySearch、synchronizedXxx(同步包装)、unmodifiableXxx(不可变包装)、emptyList。 - 常用写法:返回空结果时用
Collections.emptyList()而不是null,调用方少一层判空;synchronizedList包装需要多线程写的列表;unmodifiableList在把内部配置列表暴露出去时防止外部修改。 - 易错点:
Collections.sort要求元素实现Comparable,或者显式传入Comparator,否则抛 ClassCastException;空集合场景不要返回 null,用emptyList能让调用方少写判空。
附:原始题库(旧版逐题,与上文重叠,可折叠跳过)
展开查看原始题库
11. 深拷贝和浅拷贝的区别是什么?
浅拷贝:被复制对象的所有变量都含有与原来的对象相同的值,而所有的对其他对象的引用仍然指向原来的对象.换言之,浅拷贝仅仅复制所考虑的对象,而不复制它所引用的对象.
深拷贝:被复制对象的所有变量都含有与原来的对象相同的值.而那些引用其他对象的变量将指向被复制过的新对象.而不再是原有的那些被引用的对象.换言之.深拷贝把要复制的对象所引用的对象都复制了一遍.
12. try catch finally,try里有return,finally还执行么?
执行,并且finally的执行早于try里面的return
结论:
1、不管有木有出现异常,finally块中代码都会执行;
2、当try和catch中有return时,finally仍然会执行;
3、finally是在return后面的表达式运算后执行的(此时并没有返回运算后的值,而是先把要返回的值保存起来,管finally中的代码怎么样,返回的值都不会改变,任然是之前保存的值),所以函数返回值是在finally执行前确定的;
4、finally中最好不要包含return,否则程序会提前退出,返回值不是try或catch中保存的返回值。
13. Exception与Error包结构
Java可抛出(Throwable)的结构分为三种类型:被检查的异常(CheckedException),运行时异常 (RuntimeException),错误(Error)。
1、运行时异常
定义:RuntimeException及其子类都被称为运行时异常。
特点:Java编译器不会检查它。也就是说,当程序中可能出现这类异常时,倘若既"没有通过throws 声明抛出它",也"没有用try-catch语句捕获它",还是会编译通过。例如,除数为零时产生的
ArithmeticException异常,数组越界时产生的IndexOutOfBoundsException异常,fail-fast机制产
生的ConcurrentModificationException异常(java.util包下面的所有的集合类都是快速失败
的, “快速失败”也就是fail-fast,它是Java集合的一种错误检测机制。当多个线程对集合进行结构上的改变的操作时,有可能会产生fail-fast机制。记住是有可能,而不是一定。例如:假设存在两个线
程(线程1、线程2),线程1通过Iterator在遍历集合A中的元素,在某个时候线程2修改了集合A的结构(是结构上面的修改,而不是简单的修改集合元素的内容),那么这个时候程序就会抛出
ConcurrentModificationException 异常,从而产生fail-fast机制,这个错叫并发修改异常。 Fail- safe,java.util.concurrent包下面的所有的类都是安全失败的,在遍历过程中,如果已经遍历的数组上的内容变化了,迭代器不会抛出ConcurrentModificationException异常。如果未遍历的数组上的内容发生了变化,则有可能反映到迭代过程中。这就是ConcurrentHashMap迭代器弱一致的表现。 ConcurrentHashMap的弱一致性主要是为了提升效率,是一致性与效率之间的一种权衡。 要成为强一致性,就得到处使用锁,甚至是全局锁,这就与Hashtable和同步的HashMap一样
了。)等,都属于运行时异常。
常见的五种运行时异常:
ClassCastException(类转换异常)
IndexOutOfBoundsException(数组越界)
NullPointerException(空指针异常)
ArrayStoreException(数据存储异常,操作数组是类型不一致)
BufferOverflowException
2、被检查异常
定义:Exception类本身,以及Exception的子类中除了"运行时异常"之外的其它子类都属于被检查异常。
特点 : Java编译器会检查它。 此类异常,要么通过throws进行声明抛出,要么通过try-catch进行捕获处理,否则不能通过编译。例如,CloneNotSupportedException就属于被检查异常。当通过
clone()接口去克隆一个对象,而该对象对应的类没有实现Cloneable接口,就会抛出
CloneNotSupportedException异常。被检查异常通常都是可以恢复的。 如:
IOException
FileNotFoundException
SQLException
被检查的异常适用于那些不是因程序引起的错误情况,比如:读取文件时文件不存在引发的
FileNotFoundException。然而,不被检查的异常通常都是由于糟糕的编程引起的,比如:在对象引用时没有确保对象非空而引起的 NullPointerException。
3、错误
定义 : Error类及其子类。
特点 : 和运行时异常一样,编译器也不会对错误进行检查。
当资源不足、约束失败、或是其它程序无法继续运行的条件发生时,就产生错误。程序本身无法修复这些错误的。例如,VirtualMachineError就属于错误。出现这种错误会导致程序终止运行。
OutOfMemoryError、ThreadDeath。
Java虚拟机规范规定JVM的内存分为了好几块,比如堆,栈,程序计数器,方法区等
14. Java 序列化中如果有些字段不想进行序列化,怎么办?
对于不想进行序列化的变量,使用 transient 关键字修饰。
transient 关键字的作用是:阻止实例中那些用此关键字修饰的的变量序列化;当对象被反序列化时,被 transient 修饰的变量值不会被持久化和恢复。transient 只能修饰变量,不能修饰类和方法。
15. 说说Java 中 IO 流
Java 中 IO 流分为几种?
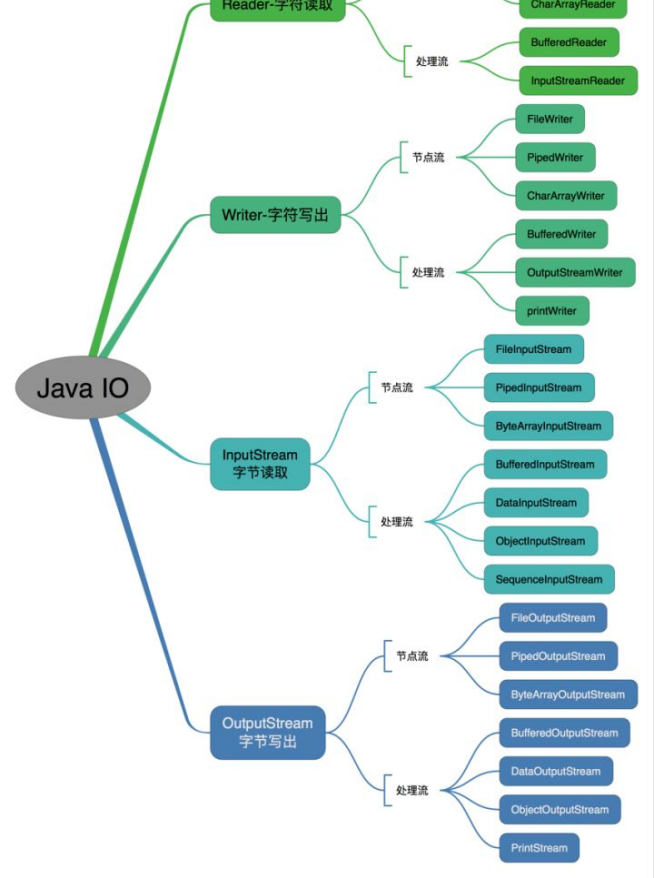
按照流的流向分,可以分为输入流和输出流;
按照操作单元划分,可以划分为字节流和字符流;
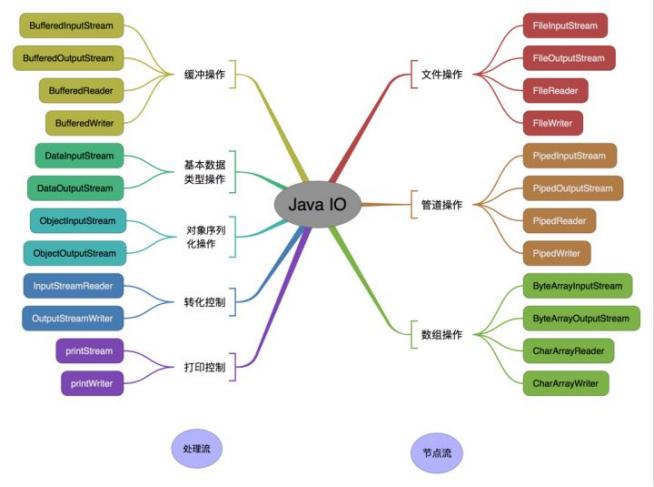
按照流的角色划分为节点流和处理流。
Java Io 流共涉及 40 多个类,这些类看上去很杂乱,但实际上很有规则,而且彼此之间存在非常紧密的联系, Java I0 流的 40 多个类都是从如下 4 个抽象类基类中派生出来的。
InputStream/Reader: 所有的输入流的基类,前者是字节输入流,后者是字符输入流。 OutputStream/Writer: 所有输出流的基类,前者是字节输出流,后者是字符输出流。
按操作方式分类结构图:
按操作对象分类结构图:
16. Java IO与 NIO的区别(补充)
NIO即New IO,这个库是在JDK1.4中才引入的。 NIO和IO有相同的作用和目的,但实现方式不同, NIO主要用到的是块,所以NIO的效率要比IO高很多。在Java API中提供了两套NIO,一套是针对标准输入输出NIO,另一套就是网络编程NIO。
17. java反射的作用与原理
1、定义:
反射机制是在运行时,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意个对象, 都能够调用它的任意一个方法。在java中,只要给定类的名字,就可以通过反射机制来获得类的所有信息。
I 这种动态获取的信息以及动态调用对象的方法的功能称为Java语言的反射机制。
2、哪里会用到反射机制?
jdbc就是典型的反射
这就是反射。如hibernate,struts等框架使用反射实现的。
3、反射的实现方式:
第一步:获取Class对象,有4中方法: 1)Class.forName(“类的路径”);2)类名.class 3)对象名.getClass() 4)基本类型的包装类,可以调用包装类的Type属性来获得该包装类的Class对象
4、实现Java反射的类:
1)Class:表示正在运行的Java应用程序中的类和接口注意: 所有获取对象的信息都需要Class类来实现。 2)Field:提供有关类和接口的属性信息,以及对它的动态访问权限。 3)Constructor: 提供关于类的单个构造方法的信息以及它的访问权限 4)Method:提供类或接口中某个方法的信息
5、反射机制的优缺点:
优点: 1)能够运行时动态获取类的实例,提高灵活性; 2)与动态编译结合缺点: 1)使用反射性能较低,需要解析字节码,将内存中的对象进行解析。 解决方案: 1、通过setAccessible(true) 关闭JDK的安全检查来提升反射速度; 2、多次创建一个类的实例时,有缓存会快很多 3、
ReflectASM工具类,通过字节码生成的方式加快反射速度 2)相对不安全,破坏了封装性(因为通过反射可以获得私有方法和属性)
18. 获取一个类Class对象的方式有哪些?
搞清楚类对象和实例对象,但都是对象。
第一种:通过类对象的 getClass() 方法获取,细心点的都知道,这个 getClass 是 Object 类里面的方法。
第二种:通过类的静态成员表示,每个类都有隐含的静态成员 class。
第三种:通过 Class 类的静态方法 forName() 方法获取。
19. 说说你平时是怎么处理 Java 异常的
try-catch-finally
try 块负责监控可能出现异常的代码
catch 块负责捕获可能出现的异常,并进行处理
finally 块负责清理各种资源,不管是否出现异常都会执行
其中 try 块是必须的,catch 和 finally 至少存在一个标准异常处理流程
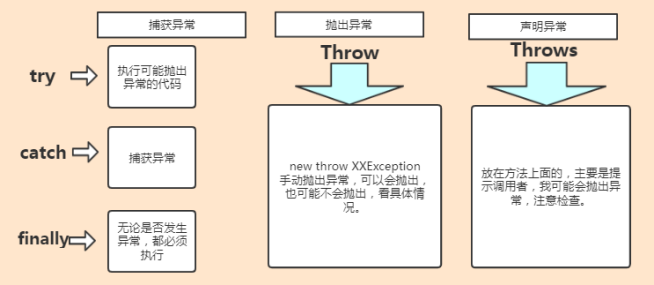
抛出异常→捕获异常→捕获成功(当 catch 的异常类型与抛出的异常类型匹配时,捕获成功) →异常被处理,程序继续运行抛出异常→捕获异常→捕获失败(当 catch 的异常类型与抛出异常类型不匹配时,捕获失败) →异常未被处理,程序中断运行
在开发过程中会使用到自定义异常,在通常情况下,程序很少会自己抛出异常,因为异常的类名通常也包含了该异常的有用信息,所以在选择抛出异常的时候,应该选择合适的异常类,从而可以明确地描述该异常情况,所以这时候往往都是自定义异常。
自定义异常通常是通过继承 java.lang.Exception 类,如果想自定义 Runtime 异常的话,可以继承 java.lang.RuntimeException 类,实现一个无参构造和一个带字符串参数的有参构造方法。
在业务代码里,可以针对性的使用自定义异常。比如说:该用户不具备某某权限、余额不足等。
20. 说说深拷贝和浅拷贝?
浅拷贝(shallowCopy)只是增加了一个指针指向已存在的内存地址,
深拷贝(deepCopy)是增加了一个指针并且申请了一个新的内存,使这个增加的指针指向这个新的内存,
使用深拷贝的情况下,释放内存的时候不会因为出现浅拷贝时释放同一个内存的错误。
最好是结合克隆已经原型模式联系在一起哈,记得复习的时候,把这几个联系起来的。
I 欢迎关注微信公众号:Java后端技术全栈
附:一句话速记(可以跳过 ★☆☆)
- 异常体系:Throwable → Error(不该捕获)/ Exception(受检 + 运行时)。
- try-with-resources:实现 AutoCloseable 即可自动关闭,比 finally 更安全。
- final / finally / finalize:finalize 已废弃(JDK9 起 @Deprecated),别再用。
- BIO / NIO / AIO:阻塞流 / 多路复用(Selector)/ 异步回调。
- 反射:Class → Constructor / Method / Field,能拿到私有成员;Spring、MyBatis 全靠它。
- 深拷贝:基本类型值拷贝、引用类型要递归克隆;浅拷贝只复制引用。
- serialVersionUID:不显式声明时反序列化容易 InvalidClassException;transient 字段不参与序列化。