 Cao Note
Java 集合与泛型
配套知识点:02 Java 核心特性
怎么用这份笔记
- 分级:
★★★ 必须吃透/★★☆ 了解即可(记结论就行)/★☆☆ 可以跳过(一句话看一眼)- 【简历亮点,高频追问】:简历里写过的技术,面试官会顺着往下挖,这段必须能展开讲
- 每个考点按「定义 → 原理 → 要点 / 易错点」组织,只讲知识点
1. ArrayList / LinkedList / 扩容 ★★★
ArrayList 基于定长数组实现,是一个会自动扩容的变长集合:按下标取元素 随机访问 O(1),中间插入删除要挪动后面的元素,复杂度 O(n);容量满后自动扩容到 1.5 倍,本质是新建数组并复制。add(e) 追加在尾部,add(index, e) 插入中间可能挪动大量元素并触发扩容;能预估大小时用 ensureCapacity() 或构造时指定初始容量,可以少扩几次容。它实现了 Cloneable 接口,可被复制,但 clone() 是浅复制;线程不安全,多线程同时操作会得到不可预知的结果。
LinkedList 是双向链表:地址不连续,头尾或指定位置增删有优势,但按下标查询要逐个遍历,访问 O(n);内存不连续、吃不到 CPU 缓存,实际性能常不如 ArrayList,业务里用得很少。选型上随机访问多用 ArrayList,需要头尾操作或队列时更常用 ArrayDeque;容量固定、只往尾部追加不触发扩容时优先 ArrayList。
注意:for-each 遍历中直接调 list.remove() 会抛 ConcurrentModificationException,应改用 iterator.remove() 或 removeIf。
补充(原文详解)
只要是搞 Java 的肯定都会回答“用过”。所以,回答题目的后半部分——ArrayList 的特点。可以从这几个方面去回答:
Java 集合框架中的一种存放相同类型的元素数据,是一种变长的集合类,基于定长数组实现,当加
入数据达到一定程度后,会实行自动扩容,即扩大数组大小。
底层是使用数组实现,添加元素。
如果 add(o),添加到的是数组的尾部,如果要增加的数据量很大,应该使用 ensureCapacity() 方法,该方法的作用是预先设置 ArrayList 的大小,这样可以大大提高初始化速度。
如果使用 add(int,o),添加到某个位置,那么可能会挪动大量的数组元素,并且可能会触发扩容机制。
高并发的情况下,线程不安全。多个线程同时操作 ArrayList,会引发不可预知的异常或错误。
ArrayList 实现了 Cloneable 接口,标识着它可以被复制。注意:ArrayList 里面的 clone() 复制其实
是浅复制。
2. HashMap 底层原理 ★★★
HashMap 的底层是「数组桶 + 链表 / 红黑树」:先用 key 的 hash 定位桶,桶为空直接放,冲突就挂成链表;链表长度达到 8 且数组长度 ≥ 64 时转为红黑树,把最坏查询从 O(n) 压到 O(logn),元素减少到 6 时退化回链表,中间留缓冲防止频繁抖动。
- 容量固定取 2 的幂:
hash % length == hash & (length - 1),用位运算代替取模;扩容时只看多出来的那一位是 0 还是 1,不用重算 hash,元素要么留在原位、要么后移一个旧容量。 - 扰动函数:
(h = key.hashCode()) ^ (h >>> 16),把高位异或进低位,降低碰撞概率。 - 负载因子 0.75 是空间与时间的折中,元素数超过
容量 × 0.75就扩容为原来的 2 倍。 - 线程不安全:1.7 头插法在并发扩容时可能成环,把 CPU 打满;并发场景应使用 ConcurrentHashMap。
3. ConcurrentHashMap ★★★
ConcurrentHashMap 的并发控制随版本演进:
- 1.7 分段锁:整个表切成若干 Segment(默认 16,即 2 的 n 次方),每个 Segment 由
Segment + HashEntry组成、配一把锁,锁的是「段」。 - 1.8 桶级锁:结构改为
Node + CAS + synchronized,写操作只对某个桶的头节点加 synchronized,空桶用 CAS 直接写入,读操作完全不加锁、靠 volatile 保证可见性;扩容时多个线程可以一起帮忙搬迁。
锁粒度从段细化到桶,并发度自然更高。另外它不允许 null 的 key 和 value:并发场景下 get 返回 null 无法区分「没有这个 key」和「存的值就是 null」,干脆禁止。
补充(原文详解)
都是 key-value 形式的存储数据;
HashMap 是线程不安全的,ConcurrentHashMap 是 JUC 下的线程安全的;
HashMap 底层数据结构是数组 + 链表(JDK 1.8 之前)。JDK 1.8 之后是数组 + 链表 + 红黑
树。当链表中元素个数达到 8 的时候,链表的查询速度不如红黑树快,链表会转为红黑树,红黑树查询速度快;
HashMap 初始数组大小为 16(默认),当出现扩容的时候,以 0.75 *数组大小的方式进行扩 容;
ConcurrentHashMap 在 JDK 1.8 之前是采用分段锁来现实的 Segment + HashEntry ,
Segment 数组大小默认是 16,2 的 n 次方;JDK 1.8 之后,采用 Node + CAS + Synchronized 来保证并发安全进行实现。
4. 集合框架选型 ★★★
集合选型按需求三条线判断:要不要有序 / 顺序、要不要去重、要不要排序、要不要并发。
- List(按序、可重复):默认 ArrayList;需要头尾操作或当队列用 ArrayDeque。
- Set(去重):HashSet 最快、无序;要保留插入顺序用 LinkedHashSet;要排序用 TreeSet。
- Map(键值对):HashMap 最快;要顺序用 LinkedHashMap;要按 key 排序用 TreeMap;要并发用 ConcurrentHashMap。
- 读多写少、并发写很少的场景可考虑 CopyOnWriteArrayList,写时复制,读不加锁。
LinkedHashMap 还能实现 LRU:构造时开启 accessOrder(访问顺序),重写 removeEldestEntry 判断容量,访问过的元素挪到链表尾部,超容量就删除最老的头部元素。
5. fail-fast 与 fail-safe ★★☆
fail-fast 是遍历时「边遍历边检查集合结构有没有变」:迭代器创建时记下 modCount(expectedModCount),每次 next() 都和当前的 modCount 比较,一旦不一致立即抛 ConcurrentModificationException。会改变元素个数的 add / remove / clear 都会触发,多线程并发修改同一个集合同样会触发。ArrayList、HashMap 等 java.util 下的集合迭代器都是这种机制。
fail-safe 是遍历快照 / 副本:修改不影响正在进行的遍历,不会抛异常,但读到的可能是旧数据。CopyOnWriteArrayList、ConcurrentHashMap 采用这种方式。
注意:for-each 里删元素要用 iterator.remove() 或 removeIf,不要直接 list.remove();并发场景用 java.util.concurrent 包下的容器替代 java.util 下的容器。
6. 函数式接口 / Lambda / Stream ★★★
函数式接口是只有一个抽象方法的接口(可用 @FunctionalInterface 校验),典型如 Function、Consumer、Supplier、Predicate。Lambda 是它的简写实现,方法引用 类::方法 是进一步简化。
Stream 是「数据源 → 中间操作(惰性,不立刻执行)→ 终结操作(触发执行)」的流水线:中间操作只是记录处理步骤,必须等到终结操作(collect、forEach、count 等)才真正执行。map 是一对一映射,flatMap 是一对多再拍平;常用能力还有过滤 filter、分组统计 Collectors.groupingBy、List 转 Map 等集合转换。
parallelStream 底层使用共享的 ForkJoinPool(默认 commonPool):里面一旦有阻塞 IO,会把整个池子的线程占住、拖垮其他并行任务,所以 IO 密集型场景不适合并行流,用普通串行流更稳。
7. Optional / Java 8 新特性 ★★★
Optional 是包装「可能为空的值」的容器,把「可能没值」这件事在方法签名上就显式化,调用方不必猜是否会返回 null。
orElse(T other)无论有没有值,都会先把参数算出来;orElseGet(Supplier)才在为空时惰性求值,所以有开销的兜底逻辑要用orElseGet。- 常用方法:
isPresent/ifPresent、map/flatMap、filter、orElseThrow。 - 使用约定:只适合当方法返回值,不当字段、不当参数,否则反而增加复杂度。
Java 8 的其他常用特性:Stream、新时间 API(LocalDate / LocalDateTime / Duration)、CompletableFuture 异步编排、接口默认方法与静态方法。
8. Comparable 与 Comparator ★★☆
Comparable 是「类自己知道自己怎么排序」:类实现 Comparable<T> 并重写 compareTo,定义自然顺序,一个类只能有一种。Collections.sort(list) 或 TreeSet / TreeMap 不传比较器时就用它。
Comparator 是「外部给类定排序规则」:不修改原类、不侵入原代码,同一个类可以定义多种排序方式,配合 lambda 或方法引用书写方便,Collections.sort(list, comparator)、list.sort(comparator) 都可传入。
多字段排序用 Comparator.comparing(...).thenComparing(...) 链式拼接,需要倒序时加 reversed(),例如先按场站、再按时间倒序。
注意:compareTo / compare 要满足自反、对称、传递,且与 equals 保持一致,否则排序、去重行为会异常。
9. 集合与流(Stream)有何不同 ★★★
集合是「数据的存储」:内存里的容器,元素都在、能反复遍历,提供增删改查;操作是急切的,add 调用后元素立即存入。
Stream 是「对数据的计算管道」:不存数据,只描述「从哪来、怎么处理、输出什么」;中间操作惰性,必须由终结操作触发执行;一次消费完就没了。
核心区别:
- 集合重存储,Stream 重计算;
- 集合可反复复用,Stream 不可复用,重复遍历会抛
IllegalStateException: stream has already been operated upon or closed,需要先把结果collect成集合; - 集合是急切的,Stream 中间操作是惰性的。
两者配合关系:集合数据源通过 .stream() 转成流做过滤、转换、分组计算,结果再用 collect 收回集合。
10. Stream 的 peek() 方法作用与副作用 ★★☆
peek 是中间操作,接收一个 Consumer,对流里每个元素执行一次,元素本身和流都不改变,主要用于调试——在流水线中间观察当前元素长什么样。
- 它也是惰性的,没有终结操作就不会执行。
- 官方明确说明其行为不保证:遇到
count、findFirst这类会短路或不需要遍历所有元素的终结操作时,peek 可能根本不被调用;并行流下执行次数和线程同样不保证。 - 因此不能拿 peek 承载业务副作用(写库、发消息等),否则会出现「莫名其妙少执行」。需要副作用应使用 forEach 终结操作,或直接写显式循环。
11. Stream 的 skip(long) 和 limit(long) 的区别 ★★☆
skip(n) 是「跳过前 n 个元素,取剩下的」;limit(n) 是「最多取前 n 个,剩下的丢弃」。两者都是中间操作、惰性,也都支持短路优化:limit 之后的元素不会再处理,先 limit 再 skip 时不需要遍历全部元素。
组合起来可做内存分页:skip((page - 1) * size).limit(size);也可用于按批切分大列表,如每批 100 个:skip(i * 100).limit(100),或直接取 Top N(limit(10))。
注意:skip 对性能不友好——它不是跳过计算,只是把前 n 个元素「丢掉」,数据源很大、偏移量很大时,前面这些元素照样会被遍历一遍。所以真正的数据库分页应在 SQL 层完成,Stream 的 skip / limit 只用于内存中小列表的切分。
12. HashMap、LinkedHashMap、TreeMap 的区别与选型 ★★★
- HashMap:哈希表,无序,增删查平均 O(1)(最坏退化到 O(logn));key 允许一个 null,可以有多个 value 为 null。
- LinkedHashMap:在 HashMap 基础上多维护一条双向链表,默认保持插入顺序;构造时把
accessOrder设为 true 就变成访问顺序,配合重写 removeEldestEntry 可实现 LRU。 - TreeMap:红黑树,key 按自然序或传入的 Comparator 排序,操作 O(logn);key 不允许 null,否则抛 NPE。
选型:要快用 HashMap,要顺序用 LinkedHashMap,要按 key 排序用 TreeMap,要并发用 ConcurrentHashMap。
易错点:TreeMap 的 key 不能为 null;HashMap 用可变对象当 key 时,若修改后 hashCode 变化、或没有正确重写 hashCode / equals,会出现 get 不到、put 覆盖不生效的问题,自定义 key 最好用不可变类。
13. ArrayList、LinkedList、Vector 的区别 ★★★
- ArrayList:数组实现,随机访问 O(1),中间增删 O(n),扩容 1.5 倍,线程不安全。
- LinkedList:双向链表,头尾增删 O(1),按下标访问要遍历 O(n),线程不安全;内存不连续、吃不到 CPU 缓存,实际很少用。
- Vector:与 ArrayList 同为数组结构,但所有公开方法都用 synchronized 修饰,线程安全却性能差,扩容默认翻倍,已基本废弃。
选型:默认用 ArrayList;需要头尾频繁增删或当队列用 ArrayDeque(比 LinkedList 更合适);需要线程安全列表用 CopyOnWriteArrayList 或 Collections.synchronizedList,不要用 Vector;更高并发场景用并发容器。
易错点:ArrayList 遍历中增删会抛 ConcurrentModificationException,要用 removeIf 或 iterator.remove()。
补充(原文详解)
ArrayList
优点:ArrayList 是实现了基于动态数组的数据结构,因为地址连续,一旦数据存储好了,查询操作效率会比较高(在内存里是连着放的)。
缺点:因为地址连续,ArrayList 要移动数据,所以插入和删除操作效率比较低。
LinkedList
优点:LinkedList 基于链表的数据结构,地址是任意的,所以在开辟内存空间的时候不需要等一个连续的地址。对于新增和删除操作,LinkedList 比较占优势。 LinkedList 适用于要头尾操作或插入指定位置的场景。
缺点:因为 LinkedList 要移动指针,所以查询操作性能比较低。
适用场景分析
当需要对数据进行对随机访问的时候,选用 ArrayList。
当需要对数据进行多次增加删除修改时,采用 LinkedList。
如果容量固定,并且只会添加到尾部,不会引起扩容,优先采用 ArrayList。
当然,绝大数业务的场景下,使用 ArrayList 就够了,但需要注意避免 ArrayList 的扩容,以及非顺序的插入。
附:原始题库(旧版逐题,与上文重叠,可折叠跳过)
展开查看原始题库
14. HashMap和HashTable的区别
1、两者父类不同
HashMap是继承自AbstractMap类,而Hashtable是继承自Dictionary类。不过它们都实现了同时实现了map、Cloneable(可复制)、 Serializable(可序列化)这三个接口。
2、对外提供的接口不同
Hashtable比HashMap多提供了elments() 和contains() 两个方法。 elments() 方法继承自 Hashtable的父类Dictionnary。elements() 方法用于返回此Hashtable中的value的枚举。
contains()方法判断该Hashtable是否包含传入的value。它的作用与containsValue()一致。事实上,contansValue() 就只是调用了一下contains() 方法。
3、对null的支持不同
Hashtable:key和value都不能为null。
HashMap:key可以为null,但是这样的key只能有一个,因为必须保证key的唯一性;可以有多个 key值对应的value为null。
4、安全性不同
HashMap是线程不安全的,在多线程并发的环境下,可能会产生死锁等问题,因此需要开发人员自己处理多线程的安全问题。
Hashtable是线程安全的,它的每个方法上都有synchronized 关键字,因此可直接用于多线程中。
虽然HashMap是线程不安全的,但是它的效率远远高于Hashtable,这样设计是合理的,因为大部分的使用场景都是单线程。当需要多线程操作的时候可以使用线程安全的ConcurrentHashMap。
ConcurrentHashMap虽然也是线程安全的,但是它的效率比Hashtable要高好多倍。因为 ConcurrentHashMap使用了分段锁,并不对整个数据进行锁定。
5、初始容量大小和每次扩充容量大小不同
6、计算hash值的方法不同
补充(原文详解)
本来不想这么写标题的,但是无奈,面试官都喜欢这么问 HashMap。
出生的版本不一样,Hashtable 出生于 Java 发布的第一版本 JDK 1.0 ,HashMap 出生于 JDK 1.2。
都实现了 Map、Cloneable、Serializable(当前 JDK 版本 1.8 )。
HashMap 继承的是 AbstractMap,并且 AbstractMap 也实现了 Map 接口。 Hashtable 继承
Dictionary。
Hashtable 中大部分 public 修饰普通方法都是 synchronized 字段修饰的,是线程安全的, HashMap 是非线程安全的。
Hashtable 的 key 不能为 null ,value 也不能为 null,这个可以从 Hashtable 源码中的 put 方 法看到,判断如果 value 为 null 就直接抛出空指针异常,在 put 方法中计算 key 的 hash 值之 前并没有判断 key 为 null 的情况,那说明,这时候如果 key 为空,照样会抛出空指针异常。
HashMap 的 key 和 value 都可以为 null。在计算 hash 值的时候,有判断,如果 key==null ,则其 hash=0 ;至于 value 是否为 null ,根本没有判断过。
Hashtable 直接使用对象的 hash 值。hash 值是 JDK 根据对象的地址或者字符串或者数字算出 来的 int 类型的数值。然后再使用除留余数法来获得最终的位置。然而除法运算是非常耗费时 间的,效率很低。 HashMap 为了提高计算效率,将哈希表的大小固定为了 2 的幂,这样在取 模预算时,不需要做除法,只需要做位运算。位运算比除法的效率要高很多。
Hashtable、 HashMap 都使用了 Iterator。而由于历史原因,Hashtable 还使用了 Enumeration 的方式。
默认情况下,初始容量不同,Hashtable 的初始长度是 11,之后每次扩充容量变为之前的 2n+1( n 为上一次的长度)而 HashMap 的初始长度为 16 ,之后每次扩充变为原来的两倍。
另外在 Hashtable 源码注释中有这么一句话:
大致意思:Hashtable 是线程安全,推荐使用 HashMap 代替 Hashtable;如果需要线程安全高并发的话,推荐使用 ConcurrentHashMap 代替 Hashtable。
这个回答完了,面试官可能会继续问:HashMap 是线程不安全的,那么在需要线程安全的情况下还要考虑性能,有什么解决方式?
这里最好的选择就是 ConcurrentHashMap 了,但面试官肯定会叫你继续说一下 ConcurrentHashMap 数据结构以及底层原理等。
15. 说说List,Set,Map三者的区别?
List(对付顺序的好帮手): List接口存储一组不唯一(可以有多个元素引用相同的对象),有序的对象
Set(注重独一无二的性质): 不允许重复的集合。不会有多个元素引用相同的对象。
Map(用Key来搜索的专家): 使用键值对存储。 Map会维护与Key有关联的值。两个Key可以引用相同的对象,但Key不能重复,典型的Key是String类型,但也可以是任何对象。
16. 说说什么是 fail-fast?
fail-fast 机制是 Java 集合(Collection)中的一种错误机制。当多个线程对同一个集合的内容进行操作时,就可能会产生 fail-fast 事件。
例如:当某一个线程 A 通过 iterator 去遍历某集合的过程中,若该集合的内容被其他线程所改变了,那么线程 A 访问集合时,就会抛出 ConcurrentModificationException 异常,产生 fail-fast 事件。这里的操作主要是指 add、 remove 和 clear,对集合元素个数进行修改。
解决办法:建议使用“java.util.concurrent 包下的类”去取代“java.util 包下的类”。
可以这么理解:在遍历之前,把 modCount 记下来 expectModCount,后面 expectModCount 去
和 modCount 进行比较,如果不相等了,证明已并发了,被修改了,于是抛出
ConcurrentModificationException 异常。
17. HashMap 中的 key 我们可以使用任何类作为 key 吗?
平时可能大家使用的最多的就是使用 String 作为 HashMap 的 key,但是现在我们想使用某个自定义类作为 HashMap 的 key,那就需要注意以下几点:
如果类重写了 equals 方法,它也应该重写 hashCode 方法。
类的所有实例需要遵循与 equals 和 hashCode 相关的规则。
如果一个类没有使用 equals,你不应该在 hashCode 中使用它。
咱们自定义 key 类的最佳实践是使之为不可变的,这样,hashCode 值可以被缓存起来,拥有更好的性能。不可变的类也可以确保 hashCode 和 equals 在未来不会改变,这样就会解决与可变相关的问题了。
18. HashMap 的长度为什么是 2 的 N 次方呢?
为了能让 HashMap 存数据和取数据的效率高,尽可能地减少 hash 值的碰撞,也就是说尽量把数据能均匀的分配,每个链表或者红黑树长度尽量相等。
我们首先可能会想到 % 取模的操作来实现。
下面是回答的重点哟:
取余(%)操作中如果除数是 2 的幂次,则等价于与其除数减一的与(&)操作(也就是说 hash % length == hash &(length - 1) 的前提是 length 是 2 的 n 次方)。并且,采用二进制位操作 &,相对于 % 能够提高运算效率。
这就是为什么 HashMap 的长度需要 2 的 N 次方了。
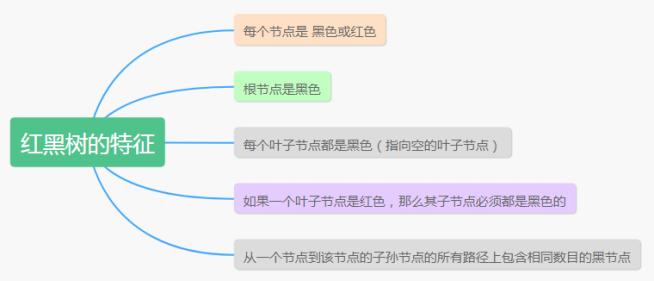
19. 红黑树有哪几个特征?
紧接上个问题,面试官很有可能会问红黑树,下面把红黑树的几个特征列出来:
附:一句话速记(可以跳过 ★☆☆)
- ArrayList:数组、随机访问快、尾部插入快、中间插入慢,扩容 1.5 倍。
- LinkedList:双向链表、增删快、查询慢,实际项目里队列场景优先 ArrayDeque。
- HashMap:数组 + 链表 + 红黑树,容量 2 的幂,负载因子 0.75,链表长度 8 且容量 ≥ 64 才树化。
- ConcurrentHashMap:1.8 用 CAS + synchronized 锁头节点,锁粒度是桶,不是段。
- fail-fast:迭代时 modCount 变了就抛 ConcurrentModificationException;fail-safe 是拷贝一份再迭代。
- Stream:惰性求值,不调用终端操作不会执行;peek 主要用于调试,不要在里面写业务副作用。