 Cao Note
工具运维(Git / Maven / Linux / Nginx / Tomcat)
怎么用这份笔记
- 分级:
★★★ 必须吃透/★★☆ 了解即可(记结论就行)/★☆☆ 可以跳过(一句话看一眼)- 【简历亮点,高频追问】:简历里写过的技术,面试官会顺着往下挖,这段必须能展开讲
- 每个考点按「定义 → 原理 → 要点 / 易错点」组织,只讲知识点
1. Git 常用命令、merge 与 rebase 区别 ★★☆
常用命令写代码天天用,不必背;真正要讲清楚的是 merge、rebase、reset、revert 的差别。
- merge:把目标分支合并进来,保留分支历史,多一个合并提交,历史是分叉的 —— 安全。
- rebase:把自己的提交挪到目标分支后面,历史是一条直线,但会改写提交记录 —— 所以只能用在没推送出去的本地分支。
- reset vs revert:reset 移动 HEAD,会丢提交;revert 生成一个反向提交,历史保留,更安全。
- 分支规范:个人 feature 分支先 rebase 拉平历史再提 MR;公共分支(main / develop)绝对不 rebase,只用 merge,避免把别人的提交历史搞乱。
- 回退线上问题用 revert 而不是 reset,因为 reset 会丢历史。
2. Maven 依赖冲突 ★★☆
A 依赖 B(1.0)、C 依赖 B(2.0),同一个库的不同版本同时被引入就产生冲突。Maven 默认按两个原则选版本:
- 最短路径优先:依赖路径短的版本胜出;
- 最先声明优先:路径长度相同时,取
pom中先声明的那条。
典型现象是运行时报 NoSuchMethodError 这类错误:编译能过,运行才炸,因为编译期用的是另一个版本的签名。这类问题在 Spring Boot 多模块项目里比较常见,不同模块各自引了不同版本的公共库就会撞上。解决手段:
mvn dependency:tree打印依赖树,定位是哪个模块传递引进来的;<exclusion>在引入方排除掉冲突的传递依赖;dependencyManagement统一锁版本,多模块项目里由父 pom 统一管理。
3. Docker 基础概念 ★★☆
- 镜像:只读模板,分层构建;
- 容器:镜像的运行实例,共享宿主机内核;
- Dockerfile:构建镜像的脚本;
- 仓库:集中存放镜像的地方,如 Harbor / Docker Hub。
与虚拟机的区别:虚拟机虚拟一整套 OS,重、隔离彻底;容器共享内核,轻、秒级启动,隔离弱一些。分层的好处是公共层可复用,构建和传输都省。
易错点:容器内存限制和 JVM 堆要配套设置。容器有内存限制时如果 JVM 不显式设堆大小,可能被 OOM Killer 干掉(进程 exit 137),详见 04-JVM 篇。
4. Linux 常用命令:进程、日志、端口、内存 CPU ★★★ 【简历亮点,高频追问】
按场景记,不要背清单:
- 进程 / CPU:
top、ps -ef | grep、kill -9、nohup ... & - 日志:
tail -f、grep、less - 端口:
netstat -tlnp、ss -tlnp、lsof -i:8080 - 资源:
free -h(内存)、df -h(磁盘)、du -sh *(目录大小) - 文件:
find、chmod、tar -zxvf
两个典型排查场景:
- 服务起不来:先
netstat -tlnp | grep 端口看端口是不是被占了,再ps -ef看有没有残留进程。 - 磁盘告警:
df -h看到某个分区满,再du -sh *逐层往下找,多半是日志没清理。
5. 常见安全:XSS、CSRF、SQL 注入 ★★★ 【简历亮点,高频追问】
- SQL 注入:用户输入被当成 SQL 拼进去了(典型 payload
' OR '1'='1)。防御核心是预编译(#{}/ PreparedStatement),让参数只能当值、不能当语法;MyBatis 里禁止用${}拼接。 - XSS:恶意脚本被注入页面并在浏览器执行,偷 cookie、冒充用户操作。防御:输出转义、CSP、Cookie 加 HttpOnly、输入过滤。
- CSRF:诱导你在已登录状态下点恶意链接,冒充你发请求。防御:CSRF Token、SameSite Cookie、校验 Referer。
- 区别一句话:XSS 是注入脚本利用「用户」,CSRF 是利用「登录态」冒用身份。
- 密码存法:加盐哈希(BCrypt),不能明文、不能裸 MD5。
6. 越权漏洞(IDOR)★★★ 【简历亮点,高频追问】
- 水平越权:同级用户之间越界,A 用户改一下 URL 里的 id 就能看到 B 用户的数据。
- 垂直越权:普通用户访问了管理员功能,低权限干了高权限的事。
- 防御关键:服务端必须做资源归属校验,正确做法是查询时就把当前用户的身份条件带进查询(如
where user_id = 当前用户),而不是查出结果再判断,这样从根上避免越权。 - 前端隐藏按钮只能算体验优化,不算安全措施。
7. 线上排查完整流程 ★★★ 【简历亮点,高频追问】
固定五步:
- 确认现象:报错内容、影响范围、能否复现。
- 看监控:CPU / 内存 / GC / 慢 SQL / 错误率,先判断是资源问题还是逻辑问题。
- 看日志:读错误堆栈,用 traceId 串联一次请求的完整链路。
- 定位:按现象分头查,见下面的口诀。
- 修复 + 验证 + 复盘加监控:光修完不加告警,下次还会被打个措手不及。
定位的口诀:
- CPU 高 →
top+top -Hp+jstack - 内存高 / OOM → dump + MAT
- 响应慢 → 查慢 SQL、下游服务、GC 频率
- 报错 → 直接看堆栈
典型例子:接口偶发变慢,最后定位到 Redis 大 key 阻塞(见 06-Redis 篇)。
8. 线程 dump 分析 ★★☆
用 jstack pid > dump.txt 导出线程快照,重点看线程状态:BLOCKED(等锁)、WAITING、RUNNABLE。JDK 自带的死锁检测会直接打印出死锁线程和锁的持有关系。大量 BLOCKED 说明锁竞争严重,要顺着 dump 找「谁持有锁」。
排查 CPU 飙高的标准动作:top 找进程 → top -Hp 找最耗 CPU 的线程 → 把线程 id 转成十六进制 → 在 jstack 输出里搜这个 nid,定位到具体代码行(与 02-JVM 篇是同一套手法)。
9. JVM 调优参数 ★★☆
详见 04-JVM 篇,核心就几个:
-Xms/-Xmx:初始堆和最大堆,生产一般设为相同值,避免运行期扩容;-XX:+UseG1GC:启用 G1 收集器;-XX:MaxGCPauseMillis:G1 的期望最大停顿时间目标;- OOM 时 dump:
-XX:+HeapDumpOnOutOfMemoryError(配-XX:HeapDumpPath指定路径),保留现场给 MAT 分析。
容器环境尤其要显式设堆:容器内存限制要和 JVM 堆配套,不设 -Xmx 会让 JVM 的内存认知和容器限制不一致,进程被 OOM Killer 杀掉(exit 137)。
10. 日志框架与监控体系 ★★☆
日志:
- SLF4J 门面 + Logback 实现,业务代码面向门面编程,换实现不用改代码;
- 级别从细到粗 TRACE / DEBUG / INFO / WARN / ERROR;
- 输出最好用结构化 JSON,并打 traceId 贯穿全链路,排查时能把同一次请求的日志串起来;
- 不打印敏感信息:手机号、身份证这类字段要脱敏。
监控:
- 指标:Prometheus 采集 + Grafana 展示;
- 链路:SkyWalking;
- 日志:ELK;
- 配阈值告警(接口耗时、错误率等)。
11. 如果程序员删库跑路了,怎么恢复数据 ★★★ (场景题)
思路三步走:
- 止损:立刻停写、锁访问,别再让数据被覆盖。
- 恢复:先恢复最近的全量备份,再用 binlog 增量回放到删库前一刻,回放时过滤掉 drop/delete 那一段。
- 救命:如果从库没被同步删掉(尤其延迟从库),直接从从库捞数据。
预防比恢复更重要 —— 定期全量备份 + 开 binlog + 异地备份、配置延迟从库、生产库不给开发 drop 权限、删除走逻辑删除(is_deleted 标记)、定期做恢复演练。
12. 删除数据的几种恢复手段 ★★☆
- 备份恢复:全量备份 + binlog 增量回放,最通用的兜底手段。
- 延迟从库:故意慢同步(如延迟一段时间),主库误删时从库还有数据,可以在延迟窗口内拦截。
- 闪回(Flashback):把 binlog 里的 delete/update 反向解析成 insert/update,工具如 binlog2sql、MyFlash。
- 回收站:部分云数据库支持 drop 先入回收站,可以从回收站找回。
13. 在线调试工具 Arthas ★★☆ 【简历亮点,高频追问】
阿里开源的 Java 在线诊断工具,原理是 attach 到运行中的 JVM,不用重启、不用改代码就能排查线上问题。和 jstack / jmap 这类 JDK 自带、功能单一的工具相比,Arthas 是交互式在线诊断:能反编译类、观测方法入参出参、追踪调用耗时。
最常用的几个命令:
dashboard:总览线程 / 内存 / GC;thread -n 3:最忙的 3 个线程;thread -b直接找死锁;trace 类 方法:看方法调用耗时,定位性能瓶颈;watch 类 方法 '{params, returnObj, throwExp}':看入参、返回值、异常,不用加日志重新发版;jad 类名:反编译,确认线上跑的到底是哪个版本的代码,比猜更可靠。
附:原始题库(旧版逐题,与上文重叠,可折叠跳过)
展开查看原始题库
14. Git和SVN有什么区别?
| Git | SVN |
|---|---|
| 1. Git是一个分布式的版本控制工具 | 1. SVN 是集中版本控制工具 |
| 2.它属于第3代版本控制工具 | 2.它属于第2代版本控制工具 |
| 3.客户端可以在其本地系统上克隆整个存储库 | 3.版本历史记录存储在服务器端存储库中 |
| 4.即使离线也可以提交 | 4.只允许在线提交 |
| 5.Push/pull 操作更快 | 5.Push/pull 操作较慢 |
| 6.工程可以用 commit 自动共享 | 6.没有任何东西自动共享 |
15. 什么是Git?
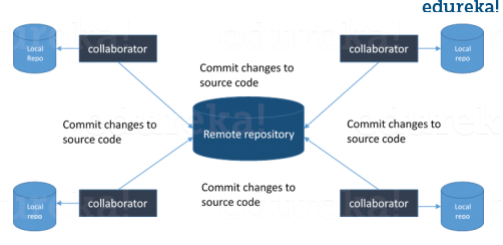
我建议你先通过了解 git 的架构再来回答这个问题,如下图所示,试着解释一下这个图:
Git 是分布式版本控制系统(DVCS)。它可以跟踪文件的更改,并允许你恢复到任何特定版本的更改。
与 SVN 等其他版本控制系统(VCS)相比,其分布式架构具有许多优势,一个主要优点是它不依赖于中央服务器来存储项目文件的所有版本。
每个开发人员都可以“克隆”我在图中用“Local repository”标注的存储库的副本,并且在他的硬盘驱动器上具有项目的完整历史记录,因此当服务器中断时,你需要的所有恢复数据都在你队友的本地 Git 存储库中。
还有一个中央云存储库,开发人员可以向其提交更改,并与其他团队成员进行共享,如图所示,所有协作者都在提交更改“远程存储库”。
16. 在 Git 中提交的命令是什么?
现在解释一下 -a 标志, 通过在命令行上加 -a 指示 git 提交已修改的所有被跟踪文件的新内容。 还要提一下,如果你是第一次需要提交新文件,可以在在 git commit -a 之前先 git add。4、什么是 Git 中的“裸存储库”?你应该说明 “工作目录” 和 “裸存储库” 之间的区别。 Git 中的 “裸” 存储库只包含版本控制信息而没有工作文件(没有工作树),并且它不包含特殊的 .git 子目录。相反,它直接在主目录本身包含 .git 子目录中的所有内容,其中工作目录包括:
答案非常简单。 用于写入提交的命令是 git commit -a。
一个 .git 子目录,其中包含你的仓库所有相关的 Git 修订历史记录。
工作树,或签出的项目文件的副本。
17. Git 是用什么语言编写的?
你需要说明使用它的原因,而不仅仅是说出语言的名称。我建议你这样回答:
Git使用 C 语言编写。 GIT 很快,C 语言通过减少运行时的开销来做到这一点。
18. 在Git中,你如何还原已经 push 并公开的提交?
There can be two answers to this question and make sure that you include both because any of the below options can be used depending on the situation: 1 这个问题可以有两个答案,你回答时也要保包含这两个答案,因为根据具体情况可以使用以下选项:
删除或修复新提交中的错误文件,并将其推送到远程存储库。这是修复错误的最自然方式。对文件进行必要的修改后,将其提交到我将使用的远程存储库
git commit -m "commit message"git commit -m "commit message"创建一个新的提交,撤消在错误提交中所做的所有更改。可以使用命令:
commit>git revert <name of badcommit>git revert <name of bad19. git pull 和 git fetch 有什么区别?
git pull 命令从中央存储库中提取特定分支的新更改或提交,并更新本地存储库中的目标分支。git pull 命令从中央存储库中提取特定分支的新更改或提交,并更新本地存储库中的目标分支。git fetch 也用于相同的目的,但它的工作方式略有不同。当你执行 git fetch 时,它会从所需的分支中提取所有新提交,并将其存储在本地存储库中的新分支中。如果要在目标分支中反映这些更改,必须在 git fetch 之后执行 git merge。只有在对目标分支和获取的分支进行合并后才会更新目标分支。为了方便起见,请记住以下等式:
git pull = git fetch + git merge
20. git中的“staging area”或“index”是什么?
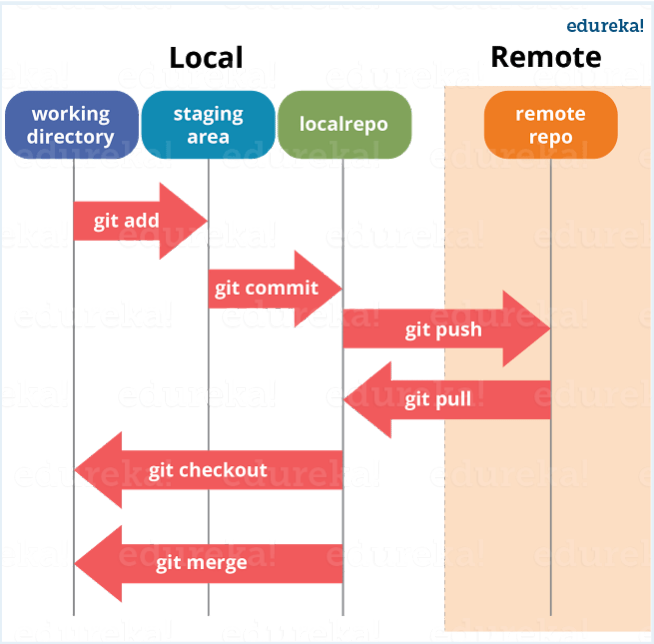
For this answer try to explain the below diagram as you can see: 可以通过下图进行解释:
在完成提交之前,可以在称为“staging area”或“index”的中间区域中对其进行格式化和审查。从图中可以看出,每个更改首先在暂存区域中进行验证,我将其称为“stage file”,然后将更改提交到存储库。
21. 什么是 git stash?
首先应该解释 git stash 的必要性。
通常情况下,当你一直在处理项目的某一部分时,如果你想要在某个时候切换分支去处理其他事
情,事情会处于混乱的状态。问题是,你不想把完成了一半的工作的提交,以便你以后就可以回到当前的工作。解决这个问题的答案是 git stash。
再解释什么是git stash。
stash 会将你的工作目录,即修改后的跟踪文件和暂存的更改保存在一堆未完成的更改中,你可以随时重新应用这些更改。
补充(原文详解)
git stash drop 的目的来回答这个问题。通过说明我们使用
git stash drop 命令用于删除隐藏的项目。默认情况下,它将删除最后添加的存储项,如果提供参数的话,它还可以删除特定项。
下面举个例子。
如果要从隐藏项目列表中删除特定的存储项目,可以使用以下命令:
git stash list:它将显示隐藏项目列表,如:
stash@{0}: WIP on master: 049d078 added the index file stash@{1}: WIP on master: c264051
Revert “added file_size” stash@{2}: WIP on master: 21d80a5 added number to log
如果要删除名为 stash@{0} 的项目,请使用命令 git stash drop stash@{0}。
22. 如何找到特定提交中已更改的文件列表?
对于这个问题,不能仅仅是提供命令,还要解释这个命令究竟做了些什么。
要获取特定提交中已更改的列表文件,请使用以下命令:
git diff-tree -r
-r 标志使命令列出单个文件,而不给定提交哈希,这将列出在该提交中更改或添加的所有文件。
是仅将它们折叠到根目录名称中。
你还可以包括下面提到的内容,虽然它是可选的,但有助于给面试官留下深刻印象。
输出还将包含一些额外信息,可以通过包含两个标志把它们轻松的屏蔽掉:
git diff-tree –no-commit-id –name-only -r
-name-only 只会打印文件名而不是它们这里-no-commit-id 将禁止提交哈希值出现在输出中,而-name-only 只会打印文件名而不是它们这里-no-commit-id 将禁止提交哈希值出现在输出中,而的路径。
23. git config 的功能是什么?
首先说明为什么我们需要 git config。
git 使用你的用户名将提交与身份相关联。 git config 命令可用来更改你的 git 配置,包括你的用户名。
下面用一个例子来解释。
假设你要提供用户名和电子邮件 ID 用来将提交与身份相关联,以便你可以知道是谁进行了特定提交。为此,我将使用:
git config –global user.name "Your Name": 此命令将添加用户名。
git config –global user.email "Your E-mail Address": 此命令将添加电子邮件ID。
24. 提交对象包含什么?
Commit 对象包含以下组件,你应该提到以下这三点:
一组文件,表示给定时间点的项目状态
引用父提交对象
SHAI 名称,一个40个字符的字符串,提交对象的唯一标识。
25. 如何在Git中创建存储库?
这可能是最常见的问题,答案很简单。
要创建存储库,先为项目创建一个目录(如果该目录不存在),然后运行命令 git init。通过运行此命令,将在项目的目录中创建 .git 目录。
26. 怎样将 N 次提交压缩成一次提交?
将N个提交压缩到单个提交中有两种方式:
如果要从头开始编写新的提交消息,请使用以下命令:
git reset –soft HEAD~N &&
git commit
git reset –soft HEAD~N &&
git commit如果你想在新的提交消息中串联现有的提交消息,那么需要提取这些消息并将它们传给 git commit,可以这样:
git reset –soft HEAD~N &&
git commit –edit -m"$(git log –format=%B –reverse .HEAD@{N})"git reset –soft HEAD~N &&
git commit –edit -m"$(git log –format=%B –reverse .HEAD@{N})"27. 什么是 Git bisect?如何使用它来确定(回归)错误的来源?
我建议你先给出一个Git bisect 的小定义。
Git bisect 用于查找使用二进制搜索引入错误的提交。 Git bisect的命令是
git bisect <subcommand> <options>git bisect <subcommand> <options>既然你已经提到过上面的命令,那就解释一下这个命令会做什么。
此命令用了二进制搜索算法来查找项目历史记录中的哪个提交引入了错误。你可以通过告诉它已知包含该错误的“错误”提交以及在引入错误之前已知的“ 良好”提交来使用它。然后 git bisect 在这两个端点之间选择一个提交,并询问你所选的提交是“好”还是“坏”。它继续缩小范围,直到找到引入更改的确切提交。
28. 如果想要在提交之前运行代码性检查工具,并在测试失败时阻止提交,该怎样配置 Git 存储库?
我建议你先介绍一下完整性检查。
完整性或冒烟测试用来确定继续测试是否可行和合理。
下面解释如何实现这一目标。
这可以通过与存储库的 pre-commit hook 相关的简单脚本来完成。git 会在提交之前触发 pre-
commit hook。你可以在这个脚本中运行其他工具,例如 linters,并对提交到存储库中的更改执行完整性检查。
最后举个例子,你可以参考下面的脚本:
#!/bin/sh
files=$(git diff –cached –name-only –diff-filter=ACM | grep ‘.go$’)
if [ -z files ]; then
exit 0
fi
unfmtd=$(gofmt -l $files)
if [ -z unfmtd ]; then
exit 0
fi
echo “Some .go files are not fmt’d”
exit 1#!/bin/sh
files=$(git diff –cached –name-only –diff-filter=ACM | grep ‘.go$’)
if [ -z files ]; then
exit 0
fi
unfmtd=$(gofmt -l $files)
if [ -z unfmtd ]; then
exit 0
fi
echo “Some .go files are not fmt’d”
exit 1功能分支(Feature branching)要素分支模型将特定要素的所有更改保留在分支内。当通过自动化测试对功能进行全面测试和验证时,该分支将合并到主服务器中。 任务分支(Task branching)在此模型中,每个任务都在其自己的分支上实现,任务键包含在分支名称中。很容易看出哪个代码实现了哪个任务,只需在分支名称中查找任务键。 发布分支(Release branching)一旦开发分支获得了足够的发布功能,你就可以克隆该分支来形成发布分支。创建该分支将会启动下一个发布周期,所以在此之后不能再添加任何新功能,只有错误修复,文档生成和其他面向发布的任务应该包含在此分支中。 一旦准备好发布,该版本将合并到主服务器并标记版本号。此外,它还应该再将自发布以来已经取得的进展合并回开发分支。最后告诉他们分支策略因团队而异,所以我知道基本的分支操作,如删除、合并、检查分支等。19、如果分支是否已合并为master,你可以通过什么手段知道?答案很直接。要知道某个分支是否已合并为master,你可以使用以下命令: git branch –merged 它列出了已合并到当前分支的分支。这个问题被要求用Git来测试你的分支经验,告诉他们你在以前的工作中如何使用分支以及它的用途是什么,你可以参考以下提到的要点:这段脚本检查是否需要通过标准 Go 源代码格式化工具 gofmt 传递所有即将提交的 .go 文件。如果脚步以非 0 状态退出,脚本会有效地阻止提交操作。18.、描述一下你所使用的分支策略?
git branch –no-merged 它列出了尚未合并的分支。 git branch –no-merged 它列出了尚未合并的分支。29. 什么是SubGit?
SubGit 是将 SVN 到 Git迁移的工具。它创建了一个可写的本地或远程 Subversion 存储库的 Git 镜像,并且只要你愿意,可以随意使用 Subversion 和 Git。
这样做有很多优点,比如你可以从 Subversion 快速一次性导入到 Git 或者在 Atlassian Bitbucket Server 中使用SubGit。我们可以用 SubGit 创建现有 Subversion 存储库的双向 Git-SVN 镜像。你可以在方便时 push 到 Git 或提交 Subversion。同步由 SubGit 完成。
30. 列举工作中常用的几个git命令?
新增文件的命令:git add file或者git add . 提交文件的命令:git commit –m或者git commit –a 查
看工作区状况:git status –s 拉取合并远程分支的操作:git fetch/git merge或者git pull 查看提交
记录命令:git reflog
31. 如果本次提交误操作,如何撤销?
如果想撤销提交到索引区的文件,可以通过git reset HEAD file;如果想撤销提交到本地仓库的文件,可以通过git reset –soft HEAD^n恢复当前分支的版本库至上一次提交的状态,索引区和工作空间不变更;可以通过git reset –mixed HEAD^n恢复当前分支的版本库和索引区至上一次提交的
32. 你使用过git stash命令吗?你一般什么情况下会使用它?
命令git stash是把工作区修改的内容存储在栈区。 以下几种情况会使用到它:
解决冲突文件时,会先执行git stash,然后解决冲突;
遇到紧急开发任务但目前任务不能提交时,会先执行git stash,然后进行紧急任务的开发,然后通过git stash pop取出栈区的内容继续开发;
切换分支时,当前工作空间内容不能提交时,会先执行git stash再进行分支切换;
33. 如何查看分支提交的历史记录?查看某个文件的历史记录呢?
查看分支的提交历史记录:
命令git log –number:表示查看当前分支前number个详细的提交历史记录;
命令git log –number –pretty=oneline:在上个命令的基础上进行简化,只显示sha-1码和提交信息;
命令git reflog –number: 表示查看所有分支前number个简化的提交历史记录; 命令git reflog –number –pretty=oneline:显示简化的信息历史信息;
如果要查看某文件的提交历史记录,直接在上面命令后面加上文件名即可。
注意:如果没有number则显示全部提交次数。
34. 使用过git merge和git rebase吗?它们之间有什么区别?
简单的说,git merge和git rebase都是合并分支的命令。 git merge branch会把branch分支的差异内容pull到本地,然后与本地分支的内容一并形成一个committer对象提交到主分支上,合并后的分支与主分支一致; git rebase branch会把branch分支优先合并到主分支,然后把本地分支的
commit放到主分支后面,合并后的分支就好像从合并后主分支又拉了一个分支一样,本地分支本身不会保留提交历史。
35. 使用过git cherry-pick,有什么作用?
命令git cherry-pick可以把branch A的commit复制到branch B上。 在branch B上进行命令操作:
复制单个提交:git cherry-pick commitId
复制多个提交:git cherry-pick commitId1…commitId3
注意:复制多个提交的命令不包含commitId1
36. 什么是maven?
maven主要服务于基于java平台的项目构建,依赖管理和项目信息管理。
maven项目对象模型(POM),可以通过一小段描述信息来管理项目的构建,报告和文档的项目管理工具软件。它包含了一个项目对象模型,一组标准集合,一个项目生命周期,一个依赖管理系统和用来运行定义在生命周期阶段中插件目标的逻辑。当使用Maven的时候,你用一个明确定义的项目对象模型来描述你的项目,然后Maven可以应用横切的逻辑,这些逻辑来自于一组共享的(或自定义的)插件。
补充(原文详解)
Maven其中一个核心的作用就是管理项目的依赖,引入我们所需的各种jar包等。为了能自动化的解析任何一个Java构件,Maven必须将这些Jar包或者其他资源进行唯一标识,这是管理项目的依赖的基础,也就是我们要说的坐标。包括我们自己开发的项目,也是要通过坐标进行唯一标识的,这样才能才其它项目中进行依赖引用。
maven的坐标通过groupId,artifactId,version唯一标志一个构件。groupId通常为公司或组织名字,artifactId通常为项目名称,versionId为版本号。
37. Maven能为我们解决什么问题?
①添加第三方jar包
按照最原始的做法,我们是手动复制jar包到项目WEB-INF/lib下,每个项目都会有一份,造成大量重复文件。而Maven将jar包放在本地仓库中统一管理,需要jar包只需要用坐标的方式引用即可。
②jar包之间的依赖关系
jar包之间往往不是独立的,很多jar需要在其他jar包的支持下才能够正常工作,称为jar包之间的依赖关系。如果我们手动去导入,要知道jar包之间的依赖关系并一一导入是及其麻烦而且容易出错的。如果使用Maven,它能够将当前jar包所依赖的其他所有jar包全部导入。
③获取第三方jar包
开发过程中我们需要用到很多jar包,每个jar包在官网获取的方式不尽相同,给工作带来了额外困难。但是使用Maven可以以坐标的方式依赖一个jar包,Maven从中央仓库进行下载,并同时下载这
个jar包依赖的其他jar包。
④将项目拆分为多个工程模块
项目的规模越来越大,已经不可能通过package结构来划分模块,必须将项目拆分为多个工程协同开发。
38. 说说maven有什么优缺点?
优点
简化了项目依赖管理
易于上手,对于新手来说了解几个常用命令即可满足日常工作
便于与持续集成工具(jenkins)整合
便于项目升级,无论是项目本身还是项目使用的依赖
maven有很多插件,便于功能扩展,比如生产站点,自动发布版本等
为什么使用Maven中的各点
缺点
Maven是一个庞大的构建系统,学习难度大。(很多都可以这样说,入门容易[优点]但是精通难[缺点])
Maven采用约定约定优于配置的策略,虽然上手容易但是一旦出现问题,难于调试中网络环境较差,很多repository无法访问
39. 讲一下maven的生命周期
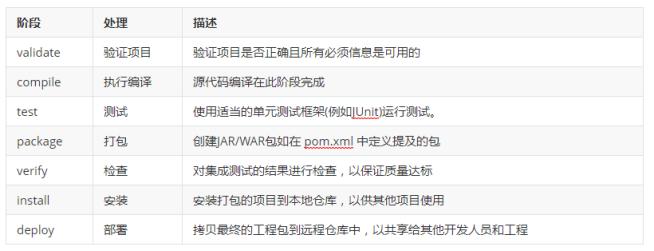
Maven的生命周期:从我们的项目构建,一直到项目发布的这个过程。
每个阶段的说明:
40. 说说你熟悉哪些maven命令?
mvn archetype:generate 创建Maven项目
mvn compile 编译源代码
mvn deploy 发布项目
mvn test-compile 编译测试源代码
mvn test 运行应用程序中的单元测试
mvn site 生成项目相关信息的网站
mvn clean 清除项目目录中的生成结果
mvn package 根据项目生成的jar
mvn install 在本地Repository中安装jar
mvn eclipse:eclipse 生成eclipse项目文件
mvnjetty:run 启动jetty服务
mvntomcat:run 启动tomcat服务
mvn clean package -Dmaven.test.skip=true:清除以前的包后重新打包,跳过测试类
41. 如何解决依赖传递引起的版本冲突?
可通过dependency的exclusion元素排除掉依赖。
42. 说说maven的依赖原则
最短路径原则(依赖传递的路径越短越优先)
pom文件申明顺序优先(路径长度一样,则先申明的优先)
覆写原则(当前pom文件里申明的直接覆盖父工程传过来的)
43. 说说依赖的解析机制?
当依赖的范围是 system 的时候,Maven 直接从本地文件系统中解析构件。
根据依赖坐标计算仓库路径,尝试直接从本地仓库寻找构件,如果发现对应的构件,就解析成功。
如果在本地仓库不存在相应的构件,就遍历所有的远程仓库,发现后,下载并解析使用。
如果依赖的版本是 RELEASE 或 LATEST,就基于更新策略读取所有远程仓库的元数据文件 ( groupId/artifactId/maven-metadata.xml),将其与本地仓库的对应元合并后,计算出 RELEASE 或者 LATEST 真实的值,然后基于该值检查本地仓库,或者从远程仓库下载。
如果依赖的版本是 SNAPSHOT,就基于更新策略读取所有远程仓库的元数据文件,将它与本地仓库
对应的元数据合并,得到最新快照版本的值,然后根据该值检查本地仓库,或从远程仓库下载。
如果最后解析得到的构件版本包含有时间戳,先将该文件下载下来,再将文件名中时间戳信息删除,剩下 SNAPSHOT 并使用(以非时间戳的形式使用)。
44. 说说插件的解析机制
与依赖的构件一样,插件也是基于坐标保存在Maven仓库中。在用到插件的时候会先从本地仓库查找插件,如果本地仓库没有则从远程仓库查找插件并下载到本地仓库。与普通的依赖构件不同的
是,Maven会区别对待普通依赖的远程仓库与插件的远程仓库。前面提到的配置远程仓库只会对普通的依赖有效果。当Maven需要的插件在本地仓库不存在时是不会去我们以前配置的远程仓库查找插件的,而是需要有专门的插件远程仓库。
45. 怎么查看当前进程?怎么执行退出?怎么查看当前路径?
查看当前进程: ps
*进程的详细信息; top 查看内存中进程的动态信息; kill -9 pid 杀死进程。1 ps -l 列出与本次登录有关的进程信息; ps -aux查询内存中进程信息; ps -aux | grep * 查询
执行退出: exit
查看当前路径: pwd
46. 查看文件有哪些命令
vi 文件名  #编辑方式查看,可修改
cat 文件名  #显示全部文件内容
vi 文件名 #编辑方式查看,可修改
cat 文件名 #显示全部文件内容more 文件名 #分页显示文件内容more 文件名 #分页显示文件内容less 文件名 #与 more 相似,更好的是可以往前翻页
tail 文件名 #仅查看尾部,还可以指定行数
head 文件名 #仅查看头部,还可以指定行数less 文件名 #与 more 相似,更好的是可以往前翻页
tail 文件名 #仅查看尾部,还可以指定行数
head 文件名 #仅查看头部,还可以指定行数47. 列举几个常用的Linux命令
列出文件列表:ls【参数 -a -l】
· 创建目录和移除目录:mkdir rmdir
用于显示文件后几行内容:tail,例如: tail -n 1000:显示最后1000行
打包:tar -xvf
打包并压缩:tar -zcvf
查找字符串:grep
显示当前所在目录:pwd创建空文件:touch
编辑器:vim vi
48. 你平时是怎么查看日志的?
Linux查看日志的命令有多种: tail、cat、tac、 head、echo等,本文只介绍几种常用的方法。
1、tail
最常用的一种查看方式
命令格式: tail[必要参数][选择参数][文件]
-f 循环读取-q 不显示处理信息 -v 显示详细的处理信息 -c<数目> 显示的字节数 -n<行数> 显示行数 - q, --quiet, --silent 从不输出给出文件名的首部 -s, --sleep-interval=S 与-f合用,表示在每次反复的间
隔休眠S秒
例如:
tail -n 10 test.log 查询日志尾部最后10行的日志;
tail -n +10 test.log 查询10行之后的所有日志;
tail -fn 10 test.log 循环实时查看最后1000行记录(最常用的)
tail -n 10 test.log 查询日志尾部最后10行的日志;
tail -n +10 test.log 查询10行之后的所有日志;
tail -fn 10 test.log 循环实时查看最后1000行记录(最常用的)一般还会配合着grep搜索用,例如 :
tail -fn 1000 test.log | grep '关键字 'tail -fn 1000 test.log | grep '关键字 '如果一次性查询的数据量太大,可以进行翻页查看,例如:
tail -n 4700 aa.log |more -1000 可以进行多屏显示(ctrl + f 或者 空格键可以快捷键)tail -n 4700 aa.log |more -1000 可以进行多屏显示(ctrl + f 或者 空格键可以快捷键)2、 head
跟tail是相反的head是看前多少行日志
head -n 10 test.log 查询日志文件中的头10行日志;
head -n -10 test.log 查询日志文件除了最后10行的其他所有日志;
head -n 10 test.log 查询日志文件中的头10行日志;
head -n -10 test.log 查询日志文件除了最后10行的其他所有日志;head其他参数参考tail
3、cat
cat 是由第一行到最后一行连续显示在屏幕上
一次显示整个文件 :
$ cat filename$ cat filename从键盘创建一个文件 :
$cat > filename$cat > filename将几个文件合并为一个文件:
$cat file1 file2 > file 只能创建新文件,不能编辑已有文件$cat file1 file2 > file 只能创建新文件,不能编辑已有文件将一个日志文件的内容追加到另外一个 :
$cat -n textfile1 > textfile2
清空一个日志文件:
$cat : >textfile2$cat : >textfile2注意: > 意思是创建, >>是追加。千万不要弄混了。
cat其他参数参考tail
4、 more
more命令是一个基于vi编辑器文本过滤器,它以全屏幕的方式按页显示文本文件的内容,支持vi中的关键字定位操作。 more名单中内置了若干快捷键,常用的有H(获得帮助信息),Enter(向下翻滚一行),空格(向下滚动一屏),Q(退出命令)。 more命令从前向后读取文件,因此在启动时就加载整个文件。
该命令一次显示一屏文本,满屏后停下来,并且在屏幕的底部出现一个提示信息,给出至今己显示的该文件的百分比: –More–( XX%)
more的语法: more 文件名
Enter 向下n行,需要定义,默认为1行
Ctrl f 向下滚动一屏
空格键向下滚动一屏
Ctrl b 返回上一屏
= 输出当前行的行号
:f 输出文件名和当前行的行号
v 调用vi编辑器
!命令调用Shell,并执行命令
q退出more
5、sed
这个命令可以查找日志文件特定的一段 , 根据时间的一个范围查询,可以按照行号和时间范围查询
按照行号
sed -n '5,10p' filename 这样你就可以只查看文件的第5行到第10行。sed -n '5,10p' filename 这样你就可以只查看文件的第5行到第10行。按照时间段
sed -n '/2014-12-17 16:17:20/,/2014-12-17 16:17:36/p' test.logsed -n '/2014-12-17 16:17:20/,/2014-12-17 16:17:36/p' test.logless与more类似,使用less可以随意浏览文件,而more仅能向前移动,不能向后移动,而且 less 在查看之前不会加载整个文件。less log2013.log 查看文件ps -ef | less ps查看进程信息并通过less分页显示history | less 查看命令历史使用记录并通过less分页显示less log2013.log log2014.log 浏览多个文件常用命令参数:-b <缓冲区大小> 设置缓冲区的大小-g 只标志最后搜索的关键词-i 忽略搜索时的大小写-m 显示类似more命令的百分比-N 显示每行的行号-o <文件名> 将less 输出的内容在指定文件中保存起来-Q 不使用警告音-s 显示连续空行为一行/字符串:向下搜索 "字符串 "的功能?字符串:向上搜索 "字符串 "的功能n:重复前一个搜索(与 / 或 ? 有关)N:反向重复前一个搜索(与 / 或 ? 有关)b 向后翻一页h 显示帮助界面q 退出less 命令
less命令在查询日志时,一般流程是这样的
less log.logshift + G 命令到文件尾部然后输入?加上你要搜索的关键字例如?1213按 n 向上查找关键字shift+n 反向查找关键字less与more类似,使用less可以随意浏览文件,而more仅能向前移动,不能向后移动,而且 less 在查看之前不会加载整个文件。less log2013.log 查看文件ps -ef | less ps查看进程信息并通过less分页显示history | less 查看命令历史使用记录并通过less分页显示less log2013.log log2014.log 浏览多个文件常用命令参数:
一般本人查日志配合应用的其他命令
history // 所有的历史记录history | grep XXX // 历史记录中包含某些指令的记录history | more // 分页查看记录history -c // 清空所有的历史记录!! 重复执行上一个命令查询出来记录后选中 : !323
49. 简述一下什么是Nginx,它有什么优势和功能?
Nginx是一个web服务器和方向代理服务器,用于HTTP、 HTTPS、SMTP、 POP3和IMAP协议。因它的稳定性、丰富的功能集、示例配置文件和低系统资源的消耗而闻名。
Nginx---Ngine X,是一款免费的、自由的、开源的、高性能HTTP服务器和反向代理服务器;
也是一个IMAP、 POP3、SMTP代理服务器;Nginx以其高性能、稳定性、丰富的功能、简单的配置和低资源消耗而闻名。
也就是说Nginx本身就可以托管网站(类似于Tomcat一样),进行Http服务处理,也可以作为反向代理服务器、负载均衡器和HTTP缓存。
Nginx 解决了服务器的C10K(就是在一秒之内连接客户端的数目为10k即1万)问题。它的设计不像传统的服务器那样使用线程处理请求,而是一个更加高级的机制—事件驱动机制,是一种异步事件驱动结构。
优点:
( 1)更快这表现在两个方面:一方面,在正常情况下,单次请求会得到更快的响应;另一方面, 在高峰期(如有数以万计的并发请求),Nginx可以比其他Web服务器更快地响应请求。
( 2)高扩展性,跨平台 Nginx的设计极具扩展性,它完全是由多个不同功能、不同层次、不同类型且耦合度极低的模块组成。因此,当对某一个模块修复Bug或进行升级时,可以专注于模块自身,
无须在意其他。而且在HTTP模块中,还设计了HTTP过滤器模块:一个正常的HTTP模块在处理完请求后,会有一串HTTP过滤器模块对请求的结果进行再处理。这样,当我们开发一个新的HTTP模块时,不但可以使用诸如HTTP核心模块、 events模块、log模块等不同层次或者不同类型的模块,还可以原封不动地复用大量已有的HTTP过滤器模块。这种低耦合度的优秀设计,造就了Nginx庞大的第三方模块,当然,公开的第三方模块也如官方发布的模块一样容易使用。 Nginx的模块都是嵌入到二进制文件中执行的,无论官方发布的模块还是第三方模块都是如此。这使得第三方模块一样具备极其优秀的性能,充分利用Nginx的高并发特性,因此,许多高流量的网站都倾向于开发符合自己业务特性的定制模块。
( 3)高可靠性:用于反向代理,宕机的概率微乎其微高可靠性是我们选择Nginx的最基本条件,因为Nginx的可靠性是大家有目共睹的,很多家高流量网站都在核心服务器上大规模使用Nginx。
Nginx的高可靠性来自于其核心框架代码的优秀设计、模块设计的简单性;另外,官方提供的常用模块都非常稳定,每个worker进程相对独立,master进程在1个worker进程出错时可以快速“拉起”新的worker子进程提供服务。
( 4)低内存消耗一般情况下,10 000个非活跃的HTTP Keep-Alive连接在Nginx中仅消耗2.5MB的内存,这是Nginx支持高并发连接的基础。
( 5)单机支持10万以上的并发连接这是一个非常重要的特性!随着互联网的迅猛发展和互联网用户数量的成倍增长,各大公司、网站都需要应付海量并发请求,一个能够在峰值期顶住10万以上并发请求的Server,无疑会得到大家的青睐。理论上,Nginx支持的并发连接上限取决于内存,10万远未封顶。当然,能够及时地处理更多的并发请求,是与业务特点紧密相关的。
( 6)热部署 master管理进程与worker工作进程的分离设计,使得Nginx能够提供热部署功能,即可以在7×24小时不间断服务的前提下,升级Nginx的可执行文件。当然,它也支持不停止服务就更新配置项、更换日志文件等功能。
( 7)最自由的BSD许可协议这是Nginx可以快速发展的强大动力。 BSD许可协议不只是允许用户免费使用Nginx,它还允许用户在自己的项目中直接使用或修改Nginx源码,然后发布。这吸引了无数
开发者继续为Nginx贡献自己的智慧。 以上7个特点当然不是Nginx的全部,拥有无数个官方功能模块、第三方功能模块使得Nginx能够满足绝大部分应用场景,这些功能模块间可以叠加以实现更加强大、复杂的功能,有些模块还支持Nginx与Perl、 Lua等脚本语言集成工作,大大提高了开发效
率。这些特点促使用户在寻找一个Web服务器时更多考虑Nginx。 选择Nginx的核心理由还是它能在支持高并发请求的同时保持高效的服务。
50. Nginx是如何处理一个HTTP请求的呢?
Nginx 是一个高性能的 Web 服务器,能够同时处理大量的并发请求。它结合多进程机制和异步机制 ,异步机制使用的是异步非阻塞方式,接下来就给大家介绍一下 Nginx 的多线程机制和异步非阻塞机制。
1、多进程机制
服务器每当收到一个客户端时,就有服务器主进程( master process)生成一个子进程( worker process)出来和客户端建立连接进行交互,直到连接断开,该子进程就结束了。
使用进程的好处是各个进程之间相互独立,不需要加锁,减少了使用锁对性能造成影响,同时降低编程的复杂度,降低开发成本。其次,采用独立的进程,可以让进程互相之间不会影响,如果一个进程发生异常退出时,其它进程正常工作, master 进程则很快启动新的 worker 进程,确保服务不会中断,从而将风险降到最低。
缺点是操作系统生成一个子进程需要进行内存复制等操作,在资源和时间上会产生一定的开销。当有大量请求时,会导致系统性能下降。
2、异步非阻塞机制
每个工作进程使用异步非阻塞方式,可以处理多个客户端请求。
当某个工作进程接收到客户端的请求以后,调用 IO 进行处理,如果不能立即得到结果,就去处理其他请求 (即为非阻塞);而客户端在此期间也无需等待响应,可以去处理其他事情(即为异步)。
当 IO 返回时,就会通知此工作进程;该进程得到通知,暂时挂起当前处理的事务去响应客户端请求。
51. 列举一些Nginx的特性
Nginx服务器的特性包括:
反向代理/L7负载均衡器
嵌入式Perl解释器
动态二进制升级
可用于重新编写URL,具有非常好的PCRE支持
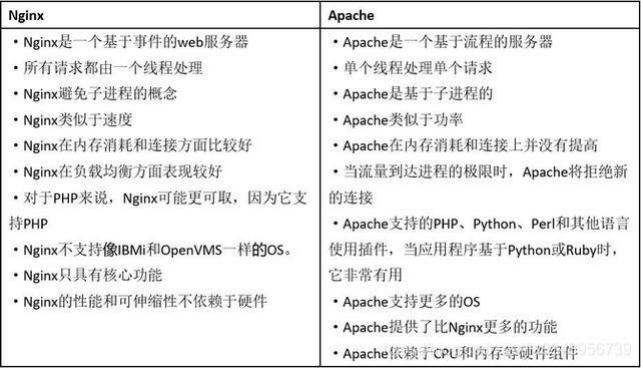
52. 请列举Nginx和Apache 之间的不同点
53. 在Nginx中,如何使用未定义的服务器名称来阻止处理请求?
只需将请求删除的服务器就可以定义为:
Server{
listen 80;
server_name "";
return 444;
}
listen 80;
server_name "";
return 444;
}这里,服务器名被保留为一个空字符串,它将在没有“主机”头字段的情况下匹配请求,而一个特殊的Nginx的非标准代码444被返回,从而终止连接。
一般推荐 worker 进程数与CPU内核数一致,这样一来不存在大量的子进程生成和管理任务,避免了进程之间竞争CPU 资源和进程切换的开销。而且 Nginx 为了更好的利用多核特性,提供了 CPU 亲缘性的绑定选项,我们可以将某一个进程绑定在某一个核上,这样就不会因为进程的切换带来
Cache 的失效。
对于每个请求,有且只有一个工作进程对其处理。首先,每个 worker 进程都是从 master进程
fork 过来。在 master 进程里面,先建立好需要 listen 的 socket(listenfd) 之后,然后再 fork 出多个 worker 进程。
所有 worker 进程的 listenfd 会在新连接到来时变得可读,为保证只有一个进程处理该连接,所有 worker 进程在注册 listenfd 读事件前抢占 accept_mutex,抢到互斥锁的那个进程注册 listenfd 读事件,在读事件里调用 accept 接受该连接。
当一个 worker 进程在 accept 这个连接之后,就开始读取请求、解析请求、处理请求,产生数据后,再返回给客户端,最后才断开连接。这样一个完整的请求就是这样的了。我们可以看到,一个请求,完全由 worker 进程来处理,而且只在一个 worker 进程中处理。
在 Nginx 服务器的运行过程中, 主进程和工作进程需要进程交互。交互依赖于 Socket 实现的管道
来实现。
54. 请解释Nginx服务器上的Master和Worker进程分别是什么?
· 主程序 Master process启动后,通过一个 for 循环来接收和处理外部信号;
主进程通过 fork() 函数产生 worker 子进程,每个子进程执行一个 for循环来实现Nginx服务器对事件的接收和处理。
55. 请解释代理中的正向代理和反向代理
首先,代理服务器一般指局域网内部的机器通过代理服务器发送请求到互联网上的服务器,代理服务器一般作用在客户端。例如:GoAgent翻墙软件。我们的客户端在进行翻墙操作的时候,我们使
用的正是正向代理,通过正向代理的方式,在我们的客户端运行一个软件,将我们的HTTP请求转发
到其他不同的服务器端,实现请求的分发。
反向代理服务器作用在服务器端,它在服务器端接收客户端的请求,然后将请求分发给具体的服务器进行处理,然后再将服务器的相应结果反馈给客户端。 Nginx就是一个反向代理服务器软件。
从上图可以看出:客户端必须设置正向代理服务器,当然前提是要知道正向代理服务器的IP地址, 还有代理程序的端口。 反向代理正好与正向代理相反,对于客户端而言代理服务器就像是原始服务器,并且客户端不需要进行任何特别的设置。客户端向反向代理的命名空间( name-space)中的内容发送普通请求,接着反向代理将判断向何处(原始服务器)转交请求,并将获得的内容返回给客户端。
56. 解释Nginx用途
Nginx服务器的最佳用法是在网络上部署动态HTTP内容,使用SCGI、WSGI应用程序服务器、用于脚本的FastCGI处理程序。它还可以作为负载均衡器。
57. Tomcat的缺省端口是多少,怎么修改?
默认端口为8080,可以通过在tomcat安装包conf目录下,service.xml中的Connector元素的port 属性来修改端口。
.Http11NioProtocol"
58. 优化)?2、tomcat 有哪几种Connector 运行模式(
这三种模式的不同之处如下:
Tomcat7版本或更低BIO:一个线程处理一个请求。缺点:并发量高时,线程数较多,浪费资源。
版本中,在Linux系统中默认使用这种方式。
tomcat8.0.x中默认使用的是NIO:利用Java的异步IO处理,可以通过少量的线程处理大量的请求。
NIO。Tomcat7必须修改Connector配置来启动:
<Connector port="8080" protocol="org.apache.coyote.http11connectionTimeout="20000" redirectPort="8443"/>
APR:即Apache Portable Runtime,从操作系统层面解决io阻塞问题。Tomcat7或Tomcat8在 Win7或以上的系统中启动默认使用这种方式。
59. Tomcat有几种部署方式?
利用Tomcat的自动部署:把web应用拷贝到webapps目录(生产环境不建议放在该目录中)。Tomcat在启动时会加载目录下的应用,并将编译后的结果放入work目录下。
使用Manager App控制台部署:在tomcat主页点击“Manager App” 进入应用管理控制台,可以指定一个web应用的路径或war文件。
修改 conf/server.xml 文件部署:在 server.xml 文件中,增加Context节点可以部署应用。
增加自定义的Web部署文件:在 conf/Catalina/localhost/ 路径下增加 xyz.xml文件,内容是 Context节点,可以部署应用。
60. tomcat容器是如何创建servlet类实例?用到了什么原理?
当容器启动时,会读取在webapps目录下所有的web应用中的web.xml文件,然后对 xml文件 进行解析,并读取servlet注册信息。然后,将每个应用中注册的servlet类都进行加载,并通过 反射的方式实例化。(有时候也是在第一次请求时实例化)
在servlet注册时加上1如果为正数,则在一开始就实例化,如果不写或为负数,则第一次请求 实例化。
61. tomcat 如何优化?
tomcat作为Web服务器,它的处理性能直接关系到用户体验,下面是几种常见的优化措施:
掉对web.xml的监视,把jsp提前编辑成Servlet。有富余物理内存的情况,加大tomcat使用的jvm的内存
服务器所能提供CPU、内存、硬盘的性能对处理能力有决定性影响。
对于高并发情况下会有大量的运算,那么CPU的速度会直接影响到处理速度。
虚拟机一kb
内存在大量数据处理的情况下,将会有较大的内存容量需求,可以用-Xmx -Xms -利用缓存和压缩XX:MaxPermSize等参数对内存不同功能块进行划分。我们之前就遇到过内存分配不足,导致直处于full GC,从而导致处理能力严重下降。
硬盘主要问题就是读写性能,当大量文件进行读写时,磁盘极容易成为性能瓶颈。最好的办法还是利用下面提到的缓存。
采用集群缓存服务器,将图片、对于静态页面最好是能够缓存起来,这样就不必每次从磁盘上读。这里我们采用了Nginx作为 css、js文件都进行了缓存,有效的减少了后端tomcat的访问。
另外,为了能加快网络传输速度,开启gzip压缩也是必不可少的。但考虑到tomcat已经需要处理很多东西了,所以把这个压缩的工作就交给前端的Nginx来完成。
除了文本可以用gzip压缩,其实很多图片也可以用图像处理工具预先进行压缩,找到一个平衡
点可以让画质损失很小而文件可以减小很多。曾经我就见过一个图片从300多kb压缩到几十 ,自己几乎看不出来区别。
单个服务器性能总是有限的,最好的办法自然是实现横向扩展,那么组建tomcat集群是有效提升性
能的手段。我们还是采用了作。可以参考之前写的《利用Nginx来作为请求分流的服务器,后端多个tomcat共享session来协同工 nginx+tomcat+memcached组建web服务器负载均衡》。
优化线程数优化优化线程数优化找到ConnectoracceptCountport="8080" protocol="HTTP/1.1",增加maxThreads和acceptCount属性(使大于等于maxThreads),如下:
<Connectorport="8080" protocol="HTTP/1.1"connectionTimeout="20000"
redirectPort="8443"acceptCount="500" maxThreads="400" /><Connectorport="8080" protocol="HTTP/1.1"connectionTimeout="20000"
redirectPort="8443"acceptCount="500" maxThreads="400" />其中:
• maxThreads• minSpareThreads:tomcat可用于请求处理的最大线程数,默认是200
:tomcat初始线程数,即最小空闲线程数
• maxSpareThreads:tomcat最大空闲线程数,超过的会被关闭
• acceptCount这个数的请求将不予处理:当所有可以使用的处理请求的线程数都被使用时,可以放到处理队列中的请求数,超过 .默认100
• maxThreads• minSpareThreads:tomcat可用于请求处理的最大线程数,默认是200
:tomcat初始线程数,即最小空闲线程数
• maxSpareThreads:tomcat最大空闲线程数,超过的会被关闭
• acceptCount这个数的请求将不予处理:当所有可以使用的处理请求的线程数都被使用时,可以放到处理队列中的请求数,超过 .默认100使用线程池优化使用线程池优化在server.xml中增加executor节点,然后配置connector的executor属性,如下:
<Executor name="tomcatThreadPool" namePrefix="req-exec-"maxThreads="1000" minSpareThreads="50"maxIdleTime="60000"/>
<Connector port="8080" protocol="HTTP/1.1"executor="tomcatThreadPool"/><Executor name="tomcatThreadPool" namePrefix="req-exec-"maxThreads="1000" minSpareThreads="50"maxIdleTime="60000"/>
<Connector port="8080" protocol="HTTP/1.1"executor="tomcatThreadPool"/>http://localhost:8080/path/****。
其中:
• namePrefix:线程池中线程的命名前缀
• maxThreads:线程池的最大线程数
• minSpareThreads:线程池的最小空闲线程数
• maxIdleTime:超过最小空闲线程数时,多的线程会等待这个时间长度,然后关闭
• threadPriority:线程优先级
• namePrefix:线程池中线程的命名前缀
• maxThreads:线程池的最大线程数
• minSpareThreads:线程池的最小空闲线程数
• maxIdleTime:超过最小空闲线程数时,多的线程会等待这个时间长度,然后关闭
• threadPriority:线程优先级注:当tomcat并发用户量大的时候,单个jvm进程确实可能打开过多的文件句柄,这时会报 java.net.SocketException:Too many open files错误。可使用下面步骤检查:
• ps -ef |grep tomcat 查看tomcat的进程ID,记录ID号,假设进程ID为10001• lsof -p 10001|wc -l 查看当前进程id为10001的文件操作数• 使用命令:ulimit -a 查看每个用户允许打开的最大文件数
启动速度优化
删除没用的web应用:因为tomcat启动每次都会部署这些应用。
关闭WebSocket:websocket-api.jar和tomcat-websocket.jar 。关闭WebSocket:websocket-api.jar和tomcat-websocket.jar 。-Djava.security.egd=file:/dev/./urandom。随机数优化:设置JVM参数:
内存优化内存优化因为tomcat启动起来后就是一个java进程,所以这块可以参照JVM部分的优化思路。堆内存相关参数,比如说:
• -Xms:虚拟机初始化时的最小堆内存。
• -Xmx:虚拟机可使用的最大堆内存。 -Xms与-Xmx设成一样的值,避免JVM因为频繁的GC导致性能大起大落
• -XX:MaxNewSize:新生代占整个堆内存的最大值。
手把手教你另外还有方法区参数调整(注意:JDK版本)、垃圾收集器等优化。JVM相关参数请看:
设置JVM调优参数
62. 熟悉tomcat的哪些配置?
Context (表示一个web应用程序,通常为WAR文件,关于WAR的具体信息见servlet规范)标签。
docBase:该web应用的文档基准目录(Document Base,也称为Context Root),或者是WAR 文件的路径。可以使绝对路径,也可以使用相对于context所属的Host的appBase路径。
path:表示此web应用程序的url的前缀,这样请求的url为
host (表示一个虚拟主机)标签。name:指定主机名。javax.servlet.context.tempdir属性,servlet可以访问该目录。如果没有指定,使用 $CATALINA_HOME/work下一个合适的目录。 swallowOutput:如果该值为true,System.out和System.err的输出被重定向到web应用的 logger。如果没有指定,缺省值为falsedebug:与这个Engine关联的Logger记录的调试信息的详细程度。数字越大,输出越详细。如果没有指定,缺省为0。和/WEB-INF/classes目录的变化,自动装载新的应用程序,我们可以在不重启tomcat的情况下改变应用程序。 useNaming:如果希望Catalina为该web应用使能一个JNDI InitialContext对象,设为true。该 InitialialContext符合J2EE平台的约定,缺省值为true。 unpackWARs:如果为true,则tomcat会自动将WAR文件解压,否则不解压,直接从WAR文件中运行应用程序。
reloadable:这个属性非常重要,如果为true,则tomcat会自动检测应用程序的/WEB-INF/lib
workDir:Context提供的临时目录的路径,用于servlet的临时读/写。利用
appBase :应用程序基本目录,即存放应用程序的目录。 appBase :应用程序基本目录,即存放应用程序的目录。Logger (表示日志,调试和错误信息)标签。
className:指定logger使用的类名,此类必须实现org.apache.catalina.Logger接口。
prefix:指定log文件的前缀。
suffix:指定log文件的后缀。
timestamp:如果为true,则log文件名中要加入时间,如下例:localhost_log.2001-10-04.txt。
63. Tomcat是什么?
Tomcat 服务器Apache软件基金会项目中的一个核心项目,是一个免费的开放源代码的Web 应用服
务器(Servlet容器),属于轻量级应用服务器,在中小型系统和并发访问用户不是很多的场合下被普遍使用,是开发和调试JSP 程序的首选。
64. 什么是Servlet呢?
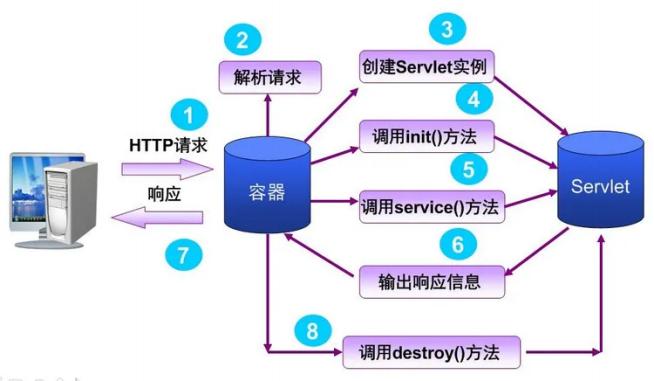
Servlet是JavaEE规范的一种,主要是为了扩展Java作为Web服务的功能,统一接口。由其他内部厂商如tomcat,jetty内部实现web的功能。如一个http请求到来:容器将请求封装为servlet中的
HttpServletRequest对象,调用init(),service()等方法输出response,由容器包装为httpresponse 返回给客户端的过程。
补充(原文详解)
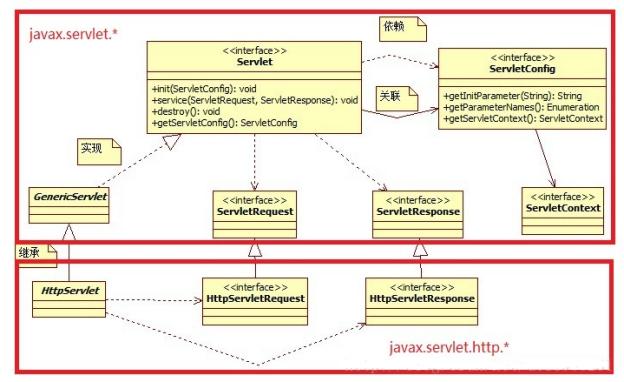
从 Jar 包上来说,Servlet 规范就是两个 Jar 文件。servlet-api.jar 和 jsp-api.jar,Jsp 也是一种 Servlet。
从package上来说,就是 javax.servlet 和 javax.servlet.http 两个包。
从接口来说,就是规范了 Servlet 接口、 Filter 接口、 Listener 接口、 ServletRequest 接口、 ServletResponse 接口等。类图如下:
65. 为什么我们将tomcat称为Web容器或者Servlet容器?
我们用一张图来表示他们之间的关系:
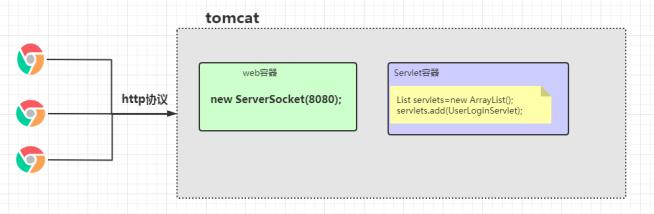
简单的理解:启动一个ServerSocket,监听8080端口。 Servlet容器用来装我们开发的Servlet。
66. tomcat是如何处理Http请求流程的?
假设来我们在浏览器上输入
http://localhost:8080/my-web-mave/index.jsp
在tomcat中是如何处理这个请求流程的:
我们的请求被发送到本机端口8080,被在那里侦听的Coyote HTTP/1.1 Connector获得。 2. Connector把该请求交给它所在的Service的Engine来处理,并等待来自Engine的回应 。
Engine获得请求我们的虚拟主机在localhost/my-web-maven/index.jsp,匹配它所拥有的所有虚拟主机Host , server.xml中默认配置的就是localhost。
Engine匹配到被定义为该name=localhost的Host(即使匹配不到也把请求交给该Host处理,因为该Host Engine的默认主机)。
localhost Host获得请求/my-web-maven/index.jsp,匹配它所拥有的所有Context。
Host匹配到路径为Context去处理)。 7. path=”/my-/my-web-maven的Context(如果匹配不到就把该请求交给路径名为 ”"的
web-maven”的Context获得请求/index.jsp,在它的mapping table中寻找对应的
servlet。
Context匹配到URL PATTERN为*.jsp的servlet,对应于JspServlet类。
构造HttpServletRequest对象和HttpServletResponse对象,作为参数调用JspServlet的doGet
或doPost方法。
- Context11. Host把把执行完了之后的HttpServletResponse对象返回给Host 。
HttpServletResponse对象返回给Engine。
Engine把HttpServletResponse对象返回给Connector 。
Connector把HttpServletResponse对象返回给客户browser 。
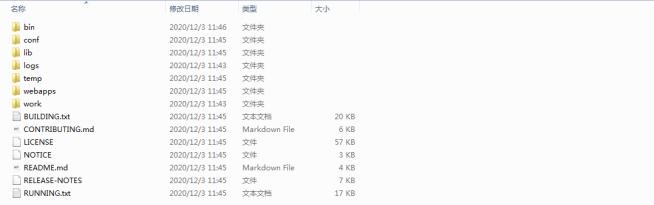
12、tomcat结构目录有哪些?
bin
启动,关闭和其他脚本。这些Windows系统)。由于.sh文件(对于Unix系统)是这些.bat文件的功能副本(对于 Win32命令行缺少某些功能,因此此处包含一些其他文件。
比如说:windows还有相应的shutdo下启动tomcat用的是startup.bat,另外Linux环境中使用的是startup.sh。对应 wn关闭脚本。
conf
tomcat的配置文件和相关的catalina.policyDTD。这里最重要的文件是server.xml。它是容器的主要配置文件。
:tomcat:安全策略文件,控制JVM相关权限,具体可以参考
java.security.Permission。
org.apache.catalina.servlets.DefaultServlet。 org.apache.jasper.servlet.JspServletlogs日志文件默认位于此处。 localhost 有用,当你们的tomcat启动不了的时候,多看这个文件。比如: NoClassDefFoundError ClassNotFoundException access 最没用。
catalina.properties:tomcat Catalina 行为控制配置文件,比如:Common ClassLoader。
logging.properties:tomcat日志配置文件。里面的日志采用的是JDK Logging。
server.xml:tomcat server配置文件(对于我开发人员来说是非常重要)。
context.xml:全局context配置文件,监视并加载资源文件,当监视的文件发生发生变化时,自动加载。
tomcat-user.xml :tomcat角色配置文件。 tomcat-user.xml :tomcat角色配置文件。web.xml:Servlet标准的web.xml部署文件,tomcat默认实现部分配置入内:
catalina.{date} 主要是控制台输出,全部日志都在这里面。 catalina.{date} 主要是控制台输出,全部日志都在这里面。webapps
这是您的webapp所在的位置。其实这里面这几个都是一个项目。
简化web部署的方式。在线上环境中我们的应用是不会放在这里的。最好的办法就是外置。
lib:tomcat存放共用的类库。比如:
ecj-4.17.jar: eclipse Java编译器
jasper.jar:JSP编译器。
work
存放tomcat运行时编译后的文件,比如JSP编译后的文件。
temp
存放运行时产生的临时文件。
附:一句话速记(可以跳过 ★☆☆)
- Jenkins / CI-CD:代码提交自动构建、测试、发布,知道流水线概念即可。
- Nginx 常用配置:反向代理、负载均衡、静态资源、限流,运维层面了解。
- JProfiler / VisualVM:本地性能分析工具,Arthas 能覆盖大部分线上需求,知道名字就行。
- SkyWalking vs Zipkin:都是链路追踪,SkyWalking 对 Java 更友好、无侵入,知道定位就行。