 Cao Note
Spring 全家桶(Spring / MyBatis / SpringBoot)
配套知识点:Java 框架技术栈、MyBatis-Plus
怎么用这份笔记
- 分级:
★★★ 必须吃透/★★☆ 了解即可(记结论就行)/★☆☆ 可以跳过(一句话看一眼)- 【简历亮点,高频追问】:简历里写过的技术,面试官会顺着往下挖,这段必须能展开讲
- 每个考点按「定义 → 原理 → 要点 / 易错点」组织,只讲知识点
1. IOC 与 DI ★★★
IOC 是思想:对象的创建和依赖由「业务代码自己 new」反转给 Spring 容器管。DI 是实现手段:容器通过构造器 / setter / 字段把依赖塞进来。好处是解耦、好测试(能注入 mock)。
注入方式及取舍:
- 构造器注入(优先):依赖可以是 final、不可变,依赖关系明确,能尽早暴露循环依赖,单测直接 new。
- Setter 注入:适合可选依赖。
- 字段注入(
@Autowired直接标字段,不推荐):隐藏依赖,单测时只能靠反射。
2. BeanFactory 与 ApplicationContext ★★☆
BeanFactory 是最底层容器,懒加载,getBean 时才创建,功能少。ApplicationContext 继承它,启动时就把单例 Bean 全建好(饿加载),还提供国际化、事件发布、资源加载、AOP 等。生产上用的都是 ApplicationContext,SpringBoot 里内置的也是它;启动稍慢,但换来启动后实时可用。
补充(原文详解)
别
类图
包目录不同
spring-beans.jar 中 org.springframework.beans.factory.BeanFactory
spring-context.jar 中 org.springframework.context.ApplicationContext
国际化
BeanFactory 是不支持国际化功能的,因为 BeanFactory 没有扩展 Spring 中 MessageResource 接口。相反,由于 ApplicationContext 扩展了 MessageResource 接口,因而具有消息处理的能力 ( i18N)。
强大的事件机制(Event)
基本上牵涉到事件(Event)方面的设计,就离不开观察者模式,ApplicationContext 的事件机制主要通过 ApplicationEvent 和 ApplicationListener 这两个接口来提供的,和 Java swing 中的事件机制一样。即当 ApplicationContext 中发布一个事件时,所有扩展了 ApplicationListener 的 Bean 都将接受到这个事件,并进行相应的处理。
底层资源的访问
ApplicationContext 扩展了 ResourceLoader(资源加载器)接口,从而可以用来加载多个 Resource,而 BeanFactory 是没有扩展 ResourceLoader。
对 Web 应用的支持
与 BeanFactory 通常以编程的方式被创建,ApplicationContext 能以声明的方式创建,如使用 ContextLoader。
当然你也可以使用 ApplicationContext 的实现方式之一,以编程的方式创建 ApplicationContext 实例。
延迟加载
- BeanFactroy 采用的是延迟加载形式来注入 Bean 的,即只有在使用到某个 Bean 时(调用
getBean()),才对该 Bean 进行加载实例化。这样,我们就不能发现一些存在的 spring 的配置问题。而 ApplicationContext 则相反,它是在容器启动时,一次性创建了所有的 Bean。这
样,在容器启动时,我们就可以发现 Spring 中存在的配置错误。
- BeanFactory 和 ApplicationContext 都支持 BeanPostProcessor、
BeanFactoryPostProcessor 的使用。两者之间的区别是:BeanFactory 需要手动注册,而 ApplicationContext 则是自动注册。
可以看到,ApplicationContext 继承了 BeanFactory,BeanFactory 是 Spring 中比较原始的
Factory,它不支持 AOP、Web 等 Spring 插件。而 ApplicationContext 不仅包含了 BeanFactory 的所有功能,还支持 Spring 的各种插件,还以一种面向框架的方式工作以及对上下文进行分层和实现继承。
BeanFactory 是 Spring 框架的基础设施,面向 Spring 本身;而 ApplicationContext 面向使用
Spring 的开发者,相比 BeanFactory 提供了更多面向实际应用的功能,几乎所有场合都可以直接使用 ApplicationContext,而不是底层的 BeanFactory。
常用容器
BeanFactory 类型的有 XmlBeanFactory,它可以根据 XML 文件中定义的内容,创建相应的 Bean。
ApplicationContext 类型的常用容器有:
ClassPathXmlApplicationContext:从 ClassPath 的 XML 配置文件中读取上下文,并生成上 下文定义。应用程序上下文从程序环境变量中取得。
FileSystemXmlApplicationContext:由文件系统中的 XML 配置文件读取上下文。
XmlWebApplicationContext:由 Web 应用的 XML 文件读取上下文。例如我们在 Spring MVC 使用的情况。
3. Bean 生命周期 ★★★
八步:实例化(构造器)→ 属性注入 → Aware 接口回调 → BeanPostProcessor 前置 → 初始化(@PostConstruct → afterPropertiesSet → init-method)→ BeanPostProcessor 后置(AOP 代理就在这一步生成)→ 使用 → 销毁(@PreDestroy → destroy → destroy-method)。
两个关键点:
@PostConstruct比InitializingBean的afterPropertiesSet先执行;- AOP 代理是在
postProcessAfterInitialization里生成的。
常见用途是启动初始化:把处理器注册表之类的结构在 @PostConstruct 或 afterPropertiesSet 里建好。BeanPostProcessor 的本质是「Bean 初始化的前后钩子,AOP 靠它实现」。
4. Bean 作用域 ★★☆
默认 singleton(容器里一个),prototype 每次拿新的,Web 里还有 request/session/application。
易错点:prototype Bean 注入到 singleton Bean 里,只会注入一次,之后不会每次新建——想每次拿新的得用 @Lookup 或注入 ObjectFactory。
5. 单例 Bean 的线程安全 ★★★ 【简历亮点,高频追问】
单例 Bean 只要「无状态」(只有方法、没有可变的成员变量)就是线程安全的。一旦在单例 Bean 里放了共享可变字段(比如一个计数器、一个 Map 当本地缓存),多线程访问就会出问题,典型现象是数据互相覆盖。
处理原则:
- 尽量无状态;
- 要状态就用 ThreadLocal 隔离,或者用并发容器 / 原子类;
- 再不行才改 prototype。
Controller 默认单例,只要不写可变成员变量就安全,方法里的局部变量天然安全。
6. 循环依赖与三级缓存 ★★☆(记结论即可)
Spring 用三级缓存解决「单例 + 字段/setter 注入」的循环依赖:一级放成品 Bean,二级放提前暴露的半成品,三级放能生成半成品的 ObjectFactory(AOP 场景下保证拿到的是代理)。
结论三条:
- 只能解决单例 + setter/字段注入;
- 构造器注入的循环依赖解决不了,直接抛
BeanCurrentlyInCreationException; - SpringBoot 2.6 之后默认禁止循环依赖,要用得手动开。
工程上遇到循环依赖优先重构(把公共逻辑抽到第三个 Bean),而不是去开开关。
7. AOP 原理(JDK 动态代理 vs CGLIB)★★★ 【简历亮点,高频追问】
AOP 就是把日志、事务、权限这些「横切逻辑」从业务代码里抽出来,用代理在方法前后织进去。
- JDK 动态代理:基于接口(
Proxy.newProxyInstance),要求目标有接口; - CGLIB:基于继承生成子类,不需要接口,但 final 类/方法代理不了。
Spring 默认「有接口用 JDK、没接口用 CGLIB」,SpringBoot 2.x 起默认直接 CGLIB。
声明式事务(@Transactional)本质就是 AOP,因此它依赖「走代理」:同一类内部 this.方法() 调用不走代理、事务就会失效。
8. @Transactional 失效场景 ★★★ 【简历亮点,高频追问】
最常见六种失效:
- 方法不是 public(事务只对 public 生效);
- 同类内部
this.xxx()自调用,不走代理; - 异常被自己 catch 吞了,事务感知不到;
- 抛的是受检异常,默认只回滚
RuntimeException/Error,要加rollbackFor = Exception.class; - 方法所在类不是 Spring Bean;
- 数据库引擎不支持事务(如 MyISAM)。
自调用的三种解法:注入自己、AopContext.currentProxy()、或者把方法抽到另一个 Bean。
工程规范:事务方法不和调用方放同一个类;受检异常一定加 rollbackFor。
9. 事务传播行为 ★★★
七种,重点记两个:
- REQUIRED(默认):有事务就加入,没有就新建;事务内任何一处回滚全体回滚。
- REQUIRES_NEW:永远新建独立事务,把当前事务挂起,内层回滚不影响外层。
其余知道名字即可:SUPPORTS、NOT_SUPPORTED、MANDATORY、NEVER、NESTED。
典型用法:主流程失败要回滚、但操作日志必须留下时,日志那块用 REQUIRES_NEW。
10. SpringBoot 自动配置原理 ★★★
@SpringBootApplication = @SpringBootConfiguration + @EnableAutoConfiguration + @ComponentScan。@EnableAutoConfiguration 通过 @Import(AutoConfigurationImportSelector) 去读 META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports(2.7 之后的新位置,老版本才是 spring.factories),拿到一堆自动配置类,再用 @ConditionalOnClass、@ConditionalOnMissingBean、@ConditionalOnProperty 判断要不要生效,从而实现「约定大于配置」。
易错点:自动配置类现在注册在 AutoConfiguration.imports,spring.factories 是 2.7 之前的老位置。封装公共能力(统一异常、日志、埋点)的内部 starter 就是这个套路:写配置类 + 在 imports 文件里注册 + 条件注解,业务服务引依赖就自动生效。
11. SpringMVC 请求处理流程 ★★★
请求先到 DispatcherServlet(前端控制器)→ HandlerMapping 按 URL 找到对应的方法 → HandlerAdapter 执行方法(做参数解析、类型转换、校验)→ 返回 ModelAndView 或者 @ResponseBody 直接写 JSON → ViewResolver 解析视图(返回 JSON 就不走这步)→ 响应。
前后端分离 + REST 接口的项目基本都走 @ResponseBody 返回 JSON 这条路径,ViewResolver 用不到;参数解析由 HandlerAdapter 里的参数解析器负责,自定义注解扩展一般也做在这里。
12. Bean 装配注解区别 ★★☆
@Autowired:Spring 的,默认按类型注入,配合@Qualifier按名字。@Resource:JDK 标准的,默认按名字,找不到再按类型。@Inject:JSR-330 的,跟@Autowired差不多。
同一个类型有多个实现时,用 @Qualifier 或 @Resource 按名字指明。
13. Spring、SpringBoot、SpringCloud 区别 ★★★
Spring 是地基:提供 IOC 和 AOP,但配置繁琐。SpringBoot 是脚手架:自动配置 + 起步依赖 + 内嵌服务器,让搭建变快。SpringCloud 是微服务工具集:注册中心、配置中心、网关、服务调用、熔断。一句话:Spring 是地基,SpringBoot 是快速建房,SpringCloud 是城市基础设施。
实际工程中多是多个独立的 SpringBoot 应用之间靠远程调用和消息串联。
14. Spring Security 鉴权链路(JWT)★★★ 【简历亮点,高频追问】
基于过滤器链:请求先过认证和授权的过滤器,再进 Controller。
JWT 认证流程:请求带 Token → 自定义 JWT 过滤器解析并校验签名和有效期 → 把用户信息塞进 SecurityContextHolder → 后续授权就基于它判断。
- JWT 是
Header.Payload.Signature三段 Base64,Payload 只放用户 id、角色这些非敏感信息。 - JWT 无状态,签出去就收不回,没法主动踢人下线;要踢人得配合 Redis 存黑名单或登录态。
- JWT 过滤器一定要排在用户名密码过滤器之前,登录、静态资源这类白名单要放行。
15. MyBatis 一级缓存、二级缓存 ★★★
- 一级缓存:SqlSession 级别,默认开,同一个 SqlSession 内相同查询走缓存;SqlSession 关闭或执行增删改就清空。
- 二级缓存:Mapper(namespace)级别,跨 SqlSession,需要显式开(
cacheEnabled=true+<cache/>),实体要序列化。
结论:MyBatis 缓存粒度粗,分布式下容易读到旧数据。服务多实例部署时二级缓存是「单机」的,A 实例改了数据、B 实例的缓存还是旧的,会读到脏数据,所以线上基本关掉二级缓存,缓存统一交给 Redis,可控、能主动失效。
16. MyBatis 执行流程 ★★☆
配置阶段解析 XML/注解生成 Configuration 和 MappedStatement;然后开 SqlSession,内部建 Executor;执行时 Mapper 接口的动态代理找到对应的 MappedStatement,Executor 交给 StatementHandler 处理参数、ResultSetHandler 把结果映射成对象。
插件(Interceptor)就是在这几个环节做动态代理拦截,分页插件(如 MyBatis-Plus 的分页插件)就是这么实现的。
17. MyBatis-Plus 相比 MyBatis 的优势 ★★☆
内置通用 CRUD(BaseMapper)、条件构造器 Wrapper、分页插件、逻辑删除、字段自动填充、代码生成器,省掉大量样板 SQL。本质还是 MyBatis 的增强,底层没变。
用法上:简单单表增删改查直接用 BaseMapper 和 Wrapper,复杂查询才手写 XML;逻辑删除、自动填充创建时间这类能力也直接启用。
18. #{} 和 ${} 区别(必考)★★★
#{} 是预编译占位符(底层是 PreparedStatement 的 ?),参数按值绑定、自动加引号、能防 SQL 注入。${} 是直接字符串拼接,不防注入,只能用在表名、列名这种不能预编译的地方,而且必须做白名单校验。
结论一句话:能用 #{} 绝不用 ${}。规范上直接禁止 ${}、用静态扫描兜底;极少数动态排序字段必须用 ${} 时,字段名要走白名单校验,这是安全底线。
19. Spring 中的设计模式 ★★★
- 工厂:
BeanFactory - 单例:默认 Bean 作用域
- 代理:AOP
- 模板方法:
JdbcTemplate/RestTemplate - 观察者:
ApplicationEvent - 适配器:
HandlerAdapter - 策略:资源处理
重点能展开的是代理模式——AOP 就是它,用来织入事务、日志。
「模板方法 + 策略」的组合也很常用:公共流程用模板方法抽出来,差异部分由子类实现;按类型分发用策略模式,新增一种类型只加一个实现类,不动主流程。
20. @Async 失效原因 ★★☆
跟事务失效一个道理,都是因为「依赖代理」:
- 同类
this自调用,不走代理; - 方法非 public;
- 类不是 Spring Bean;
- 没开
@EnableAsync。
解法和事务一样:抽到另一个 Bean、注入自身、用 AopContext.currentProxy()。底层都是 AOP 代理。异步任务用线程池或 @Async 都可以。
21. SpringMVC 参数校验、全局异常处理 ★★☆
参数校验:用 @Valid/@Validated 加 @NotNull/@NotBlank/@Size,失败抛异常,可以全局统一处理。
全局异常:用 @RestControllerAdvice + @ExceptionHandler,统一返回错误结构,别让异常堆栈直接暴露给前端。
实践中所有接口返回统一的 code/message/data 结构,参数校验失败、业务异常、系统异常都在一个 Advice 里收口,前端处理统一,也不会把栈信息漏出去。
22. Spring Cloud 核心组件 ★★★
- 注册中心:Nacos / Eureka
- 配置中心:Nacos Config
- 网关:Spring Cloud Gateway
- 服务调用:OpenFeign
- 熔断限流:Sentinel / Resilience4j
- 负载均衡:LoadBalancer
- 链路追踪:Sleuth + Zipkin 或 SkyWalking
Nacos 比 Eureka 强在「注册 + 配置一体,还支持 CP/AP 切换」。
选型上不必上全套:服务数量有限时按需用注册发现和远程调用即可,别吹成全套 Cloud 微服务体系。
23. 网关作用、Gateway 过滤器 ★★☆
API 网关的作用:统一入口、路由转发、鉴权、限流、日志、灰度。Spring Cloud Gateway 基于 WebFlux(响应式、非阻塞),过滤器分全局 GlobalFilter 和局部 GatewayFilter,断言 Predicate 按路径、方法、header 匹配路由。
注意区分:Spring Cloud Gateway 是 HTTP 层的 API 网关;基于 Netty 的 TCP 长连接网关是另一类东西(例如接设备的协议网关),两者不是一回事。
24. 微服务架构的优缺点 ★★☆
优点:独立部署、故障隔离、可独立扩展、技术栈灵活。缺点:分布式复杂度上来了——事务、一致性、网络、链路追踪、运维都变难。
拆分的代价是跨服务调用和一致性要额外处理,通常靠消息、幂等、补偿兜底。业务复杂、团队大才值得拆,小项目别硬上微服务。
25. Spring 有哪些模块 ★★☆
核心容器(Beans、Core、Context、SpEL,是 IOC 基础)、AOP、数据访问(JDBC、ORM、事务)、Web(MVC、WebFlux)、测试。SpringBoot 和 SpringCloud 都是在它之上的扩展。
真正的地基是「核心容器 + AOP」,其他都是按需加;日常用得最多的是 Web(MVC)、数据访问(MyBatis 整合 + 事务)、AOP。
26. Spring 有哪些优点 ★★☆
轻量、非侵入(POJO 不用继承 Spring 的类)、IOC 解耦、AOP 解耦横切逻辑、声明式事务、模板类简化开发、生态大、方便测试。
最实在的两个好处是声明式事务和生态整合:加个依赖注解就整合好 MyBatis、Redis、Kafka,不用自己搓。
补充(原文详解)
它为不同的事务API(如JTA, JDBC, Hibernate, JPA, 和JDO)提供了统一的编程模型。它为编程式事务管理提供了一个简单的API而非一系列复杂的事务API(如JTA).它支持声明式事务管理。它可以和
Spring 的多种数据访问技术很好的融合。
它为不同的事务API(如JTA, JDBC, Hibernate, JPA, 和JDO)提供了统一的编程模型。它为编程式事务管理提供了一个简单的API而非一系列复杂的事务API(如JTA).它支持声明式事务管理。它可以和
Spring 的多种数据访问技术很好的融合。
它为不同的事务API(如JTA, JDBC, Hibernate, JPA, 和JDO)提供了统一的编程模型。它为编程式事务管理提供了一个简单的API而非一系列复杂的事务API(如JTA).它支持声明式事务管理。它可以和
Spring 的多种数据访问技术很好的融合。
27. XML 时代的自动装配模式(byName / autodetect 等)★☆☆(已过时,一句话)
byName、byType、constructor、autodetect 是 XML 配置时代的自动装配模式,autodetect 早在 Spring 3 就废弃了。现在一律用注解:@Autowired 默认按类型、@Resource 默认按名字。
28. SpringBoot 启动流程 ★★★
main 方法创建 SpringApplication → 推断应用类型(Servlet 还是 Reactive)→ 加载初始化器和监听器 → 准备 Environment(加载配置、命令行参数、profile)→ 创建 ApplicationContext → refresh 刷新(扫描 Bean、执行自动配置)→ 启动内嵌的 Tomcat → 发布 ApplicationReadyEvent。
两个关键结论:refresh 阶段才会自动配置,内嵌 Tomcat 也是自动配置里创建的。排障时有用:启动卡住或 Bean 冲突,看日志基本卡在 refresh 阶段。
补充(原文详解)
Spring Boot 优点非常多,如:
一、独立运行
Spring Boot而且内嵌了各种servlet容器,Tomcat、Jetty等,现在不再需要打成war包部署到容器中,Spring Boot只要打成一个可执行的jar包就能独立运行,所有的依赖包都在一个jar包内。
二、简化配置
spring-boot-starter-web启动器自动依赖其他组件,简少了maven的配置。 三、自动配置
Spring Boot能根据当前类路径下的类、jar包来自动配置bean,如添加一个spring-boot-starter- web启动器就能拥有web的功能,无需其他配置。
四、无代码生成和XML配置
Spring Boot配置过程中无代码生成,也无需XML配置文件就能完成所有配置工作,这一切都是借助于条件注解完成的,这也是Spring4.x的核心功能之一。
五、应用监控
Spring Boot提供一系列端点可以监控服务及应用,做健康检测。
29. SpringBoot 核心注解 ★★★
@SpringBootApplication = @SpringBootConfiguration + @EnableAutoConfiguration + @ComponentScan。
常用的条件装配注解:
@ConditionalOnClass:类在才生效@ConditionalOnMissingBean:没有这个 Bean 才生效@ConditionalOnProperty:配置满足才生效
@Configuration + @Bean 用来声明 Bean,@Component/@Service/@Repository/@Controller 靠组件扫描,自动配置本身靠 @Import 导入选择器。
自定义 starter 或做条件化配置时就靠这三个条件注解,比如「只有当业务方引入了某个依赖、且没自己定义 Bean 时,才注入默认实现」。
30. MyBatis SqlSession 的线程安全问题 ★★★
SqlSession 不是线程安全的:它对应一个数据库连接 + 一个一级缓存,多线程共享会互相污染。所以每次操作要用一个新的、用完关闭。
跟 Spring 整合后就不用担心了——Mapper 代理是单例,但内部通过 SqlSessionTemplate 用 ThreadLocal 给每个线程绑定独立的 SqlSession。这就是「Mapper 是单例为什么不会冲突」的答案。
31. MyBatis 的优缺点 ★★☆
优点:SQL 和代码分离、可手写复杂 SQL、动态 SQL 灵活、轻量无侵入、插件扩展好。缺点:SQL 依赖数据库方言、迁移要改 SQL、样板代码多、缓存粒度粗、复杂关联还得手写 join。
选它的核心理由是「SQL 可控」:统计、多条件联合查询这类复杂查询要求能精确调优,手写 SQL 比 ORM 生成的更可控。
补充(原文详解)
优点:
( 1)基于SQL语句编程,相当灵活,不会对应用程序或者数据库的现有设计造成任何影响,SQL写在XML里,解除sql与程序代码的耦合,便于统一管理;提供XML标签,支持编写动态SQL语句,并可重用。
( 2)与JDBC相比,减少了50%以上的代码量,消除了JDBC大量冗余的代码,不需要手动开关连接;
( 3)很好的与各种数据库兼容(因为MyBatis使用JDBC来连接数据库,所以只要JDBC支持的数据库MyBatis都支持)。
( 4)能够与Spring很好的集成;
( 5)提供映射标签,支持对象与数据库的ORM字段关系映射;提供对象关系映射标签,支持对象
关系组件维护。
缺点
( 1)SQL语句的编写工作量较大,尤其当字段多、关联表多时,对开发人员编写SQL语句的功底有一定要求。
( 2)SQL语句依赖于数据库,导致数据库移植性差,不能随意更换数据库。
32. SpringBoot 的 starter 机制及自定义 starter ★★★
starter 就是一个「开箱即用的依赖包」,把某个功能需要的所有 jar 依赖 + 自动配置类打包在一起。你只要引一个 spring-boot-starter-web,它就把 SpringMVC、内嵌 Tomcat、Jackson 这些依赖和默认配置全带上了。
命名规范:官方叫 spring-boot-starter-xxx,第三方自定义叫 xxx-spring-boot-starter(前缀位置相反,一眼区分官方还是第三方)。
自定义 starter 三步:
- 写一个
@Configuration配置类; - 在
META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports里注册; - 用
@ConditionalOnXxx控制生效条件。
业务方引依赖就自动生效。注意:SpringBoot 3.x 下自动配置注册位置就是 AutoConfiguration.imports,不是老的 spring.factories。
33. SpringBoot 的父依赖 spring-boot-starter-parent 的作用 ★★☆
spring-boot-starter-parent 是 SpringBoot 提供的「父 POM」,作用三块:
- 依赖版本管理——它继承了
spring-boot-dependencies(BOM),把几乎所有常用依赖的版本锁定好,引 starter 不用写版本号; - 默认插件配置——打包、编译插件、资源过滤都配好,还指定了 Java 版本;
- 默认配置——UTF-8 编码、properties 里可用
@xxx@占位符替换等。
核心一句话:统一管版本,避免版本冲突。不继承 parent 也可以在根 pom 的 dependencyManagement 里直接 import spring-boot-dependencies 这个 BOM,效果一样,只是没有 parent 的默认插件配置,插件自己在根 pom 配——parent 的本质就是 BOM 管版本。
34. SpringBoot 中读取配置的几种方式(@Value、@ConfigurationProperties、Environment)★★★
三种:
@Value("${key}")读单个值,支持默认值@Value("${key:default}")和 SpEL;@ConfigurationProperties(prefix="xxx")把一组配置批量绑定到 POJO 类,需配合@Component或@EnableConfigurationProperties注册成 Bean;- 注入
Environment对象,用environment.getProperty("key")手动读,适合运行时动态读或非 Bean 场景。
配置优先级:命令行参数 > 环境变量 > application-{profile}.yml > application.yml(命令行最高)。
使用建议:零散开关用 @Value;一组业务配置(业务参数、阈值配置)用 @ConfigurationProperties 绑定成配置类,结构化、还能启动时校验必填项;Environment 在工具类或非 Bean 场景手动读。容器化部署常用环境变量覆盖配置(优先级高于 application.yml)。
35. @ConfigurationProperties 与 @Value 的区别 ★★★
@ConfigurationProperties:批量绑定,按 prefix 前缀把一组配置映射到 POJO 字段,支持松散绑定(user-name、userName、USER_NAME都能绑到 userName 字段)、支持绑定 List/Map 复杂类型、支持@Validated校验。@Value:只能单个属性逐个读,支持 SpEL 和默认值,但不支持松散绑定、不支持批量、不支持复杂类型,校验也不方便。
结论:一组结构化配置用 @ConfigurationProperties,零散几个值用 @Value。一组业务配置封装成配置类后,还能在启动时用 @Validated 校验必填项,避免配置漏填、上线才炸。
36. SpringBoot 启动时会扫描哪些包、如何自定义扫描路径 ★★☆
默认扫描「启动类所在包及其所有子包」——因为 @SpringBootApplication 里的 @ComponentScan 没指定 basePackages,就默认扫启动类所在包。所以启动类一般放项目根包,保证所有 @Component/@Service/@Controller 都被扫到。
自定义扫描:@SpringBootApplication(scanBasePackages = "com.xxx") 或 @ComponentScan(basePackages = {...}),也可以用 scanBasePackageClasses 按类定位。
易错点:纯 MyBatis 的 Mapper 接口 @ComponentScan 扫不到,要单独 @MapperScan 指定包,否则报「找不到 Mapper Bean」。
37. SpringBoot 支持哪些日志框架、如何切换日志实现 ★★☆
SpringBoot 默认用 SLF4J(门面)+ Logback(实现)。SLF4J 负责统一 API,实现可以换;内置 Logback 是默认实现,也支持 Log4j2。
- 换实现:排除 logback,引入
spring-boot-starter-log4j2并排除默认的 logback。 - 日志级别:TRACE < DEBUG < INFO < WARN < ERROR。
- 配置项:
logging.level.包名=级别、logging.file.name、logging.pattern.xxx。
引入第三方 starter(如阿里的 schedulerx2)时,要把它自带的 log4j-api/log4j-core 排除掉,避免日志框架打架,全部走 SLF4J 门面。日志级别按包在配置里调,关键服务线上 INFO,排查时临时调 DEBUG。
38. SpringBoot 的内置容器有哪些、如何替换 ★★☆
SpringBoot 默认内置 Tomcat,也支持 Jetty、Undertow(都是 Servlet 容器,WebFlux 场景用 Netty)。内嵌容器好处:打成 jar 直接 java -jar 跑,不用外部装 Tomcat。
替换方式:在 starter-web 里排除默认 tomcat,再引入对应的 starter(spring-boot-starter-jetty / spring-boot-starter-undertow)。
三者对比:Tomcat 生态最大最稳;Jetty 轻量、适合长连接;Undertow 性能好、内存占用低。生产主流还是 Tomcat。
注意区分:这是 HTTP 层的 Servlet 容器;基于 Netty 的 TCP 长连接服务(如设备协议网关)跟内置 Web 容器是两码事。
39. SpringBoot 中如何实现 Bean 的注入方式(构造器/Setter/字段/@Bean)★★★
四种:
- 构造器注入(最推荐):依赖写在构造器参数里,final 不可变、依赖明确、便于测试,Spring 4.3 之后单个构造器可省略
@Autowired; - Setter 注入:可选依赖用,可重新赋值;
- 字段注入(
@Autowired直接标字段,不推荐):隐藏依赖、不好测试、可能循环依赖; - @Bean 方法注入:在
@Configuration里用@Bean显式声明 Bean,适合第三方类、需要自定义构造逻辑的场景。
推荐顺序:构造器 > Setter > 字段。实践中 Service 之间统一构造器注入,第三方组件(客户端、线程池等)用 @Bean 在配置类里显式声明,字段注入由规范禁止。
40. SpringBoot 的 actuator 是什么、常用端点 ★★☆
actuator 是 SpringBoot 的「应用监控探针」,引 spring-boot-starter-actuator 就暴露一堆 HTTP 端点,能看应用健康、内存、线程、配置等。
常用端点:
/actuator/health:健康检查,探活用/actuator/info:应用信息/actuator/metrics:指标,如 JVM 内存、HTTP 请求数/actuator/env:环境配置/actuator/beans:容器里的 Bean/actuator/loggers:动态改日志级别/actuator/mappings:接口映射
安全要点:默认只暴露 health 和 info,其他端点要 management.endpoints.web.exposure.include=* 才开,而且不能裸奔,必须加鉴权 / 限制内网访问。生产上 env、beans 会泄露配置和内部结构,通常只开 health 给容器编排做存活/就绪检查。
41. 什么是 MyBatis ★★★
MyBatis 是一个半自动的 ORM(持久层)框架,它把 SQL 和 Java 代码解耦:SQL 写在 XML 或注解里,查询结果自动映射成 Java 对象(POJO)。
核心特点:
- SQL 完全由开发者手写,可控、可优化;
- 通过 XML/注解维护 SQL 和映射关系;
- 支持动态 SQL(if/foreach/where 等标签);
- 轻量、无侵入,不强制继承框架类。
对比全自动 ORM(如 Hibernate),它不自动生成 SQL,所以叫「半自动」。用 MyBatis-Plus(MyBatis 的增强)时,大量用 BaseMapper、IService、分页插件:复杂查询(统计、按条件查订单)手写 SQL 放 XML,简单单表 CRUD 用 MyBatis-Plus 直接做,不写样板 SQL。
补充(原文详解)
( 1)Mybatis是一个半ORM(对象关系映射)框架,它内部封装了JDBC,开发时只需要关注SQL 语句本身,不需要花费精力去处理加载驱动、创建连接、创建statement等繁杂的过程。程序员直接编写原生态sql,可以严格控制sql执行性能,灵活度高。
( 2)MyBatis 可以使用 XML 或注解来配置和映射原生信息,将 POJO映射成数据库中的记录,避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集。
( 3)通过xml 文件或注解的方式将要执行的各种 statement 配置起来,并通过java对象和
statement中sql的动态参数进行映射生成最终执行的sql语句,最后由mybatis框架执行sql并将结果
映射为java对象并返回。(从执行sql到返回result的过程)。
42. MyBatis 与 JDBC、Hibernate 的区别 ★★★
- JDBC:最底层,手写连接、PreparedStatement、ResultSet,还要自己管理连接、异常、资源关闭,样板代码极多。
- MyBatis:在 JDBC 上封装了连接管理、参数映射、结果映射,SQL 还是要自己写,但样板代码大幅减少,SQL 可控。
- Hibernate:全自动 ORM,用 HQL/对象操作自动生成 SQL,开发快,但复杂查询、性能调优不可控,学习成本高。
一句话:JDBC 是「手动挡」,MyBatis 是「半自动」,Hibernate 是「全自动」。
选型理由:业务里大量复杂查询(统计、多条件筛选这类)需要 SQL 可控、能精确调优,Hibernate 生成 SQL 不可控;MyBatis-Plus 又补上了单表 CRUD 的便捷性,兼顾两头。
43. 为什么说 MyBatis 是半自动 ORM ★★★
判断全自动还是半自动,看「SQL 谁来写、对象关系映射谁来做」:MyBatis 帮你做了「结果映射」这一半(查询结果自动映射成 Java 对象),但「SQL 生成」这一半要你自己写(写 XML/注解)。所以它是「半自动」。
- Hibernate 两半都自动(SQL 由框架生成),所以叫全自动 ORM;
- JDBC 两半都手动,压根不算 ORM。
实际用法就是「半自动」:SQL 全部自己写(复杂查询放 XML),映射交给框架。这样复杂 join、聚合、分页、调优都能精确控制,同时不用手写 ResultSet 映射的样板代码。
44. MyBatis 的适用场景 ★★☆
适合:
- SQL 需要精细控制、性能调优的场景;
- 复杂查询多(多表 join、动态条件、报表统计);
- 团队 SQL 能力强、想保留 SQL 自主权;
- 老系统数据库结构复杂、ORM 自动映射搞不定的。
不适合:
- 业务 CRUD 简单、对象模型清晰,全自动 ORM 更快;
- 团队不想碰 SQL。
一句话:SQL 复杂、要可控,选 MyBatis。实际落地常是「复杂 SQL 手写 + 简单 CRUD 交给 MyBatis-Plus」,兼顾两端。
45. MyBatis 核心组件有哪些(SqlSessionFactory、SqlSession、Executor、StatementHandler 等)★★★
核心组件是一条链:
SqlSessionFactoryBuilder:读配置构建 SqlSessionFactory,用完就丢;SqlSessionFactory:全局唯一、线程安全,负责生产 SqlSession;SqlSession:一次数据库会话,非线程安全,执行 SQL 的门面;Executor:真正执行器,负责缓存、事务、Statement 处理,有 Simple/Reuse/Batch 三种;StatementHandler:处理 JDBC Statement,做参数设置和结果映射;ParameterHandler/ResultSetHandler:分别设参数、映射结果;TypeHandler:Java 类型和 JDBC 类型互转;MappedStatement:封装一条 SQL 的所有信息(SQL、参数、返回值);Interceptor:插件机制,在 Executor、StatementHandler 等关键点做动态代理拦截。
组件之间是串行链路关系。最典型的对应关系:MyBatis-Plus 的分页插件就是 Interceptor,拦在 Executor 这一环改写 SQL 拼 LIMIT。
46. Mapper 接口为什么不需要实现类(动态代理原理)★★★
只定义了 Mapper 接口、没写实现类却能直接注入调用,靠的是 JDK 动态代理:MyBatis 启动时用 MapperProxyFactory 给每个 Mapper 接口生成一个代理对象(MapperProxy),它实现 InvocationHandler。
调用 mapper.xxx() 时,代理的 invoke 方法拿到「接口全限定名 + 方法名」组成 statementId,去 Configuration 里找到对应的 MappedStatement,再交给 SqlSession 执行 SQL。所以「接口没有实现类,代理类就是实现」。
由此可以推出两个约束:
- Mapper 接口方法不能重载(statementId 会冲突),否则运行时报「找不到映射」;
- Mapper 必须是 interface。
MyBatis-Plus 的 BaseMapper 也是这个原理,自定义 Mapper 继承 BaseMapper 就有通用 CRUD。
47. MyBatis 有几种 Executor 执行器 ★★☆
三种:
SimpleExecutor(默认):每次执行都创建新的 Statement,用完关闭;ReuseExecutor:复用 Statement(按 SQL 缓存复用,重复执行同一条 SQL 不重复创建);BatchExecutor:批量执行,把所有 update 攒起来批量提交,适合批量插入。
还有个 CachingExecutor 是包装器(开启二级缓存时包在真执行器外面)。SpringBoot 里默认 SimpleExecutor,全局配置 mybatis.executor-type=batch 可改。
易错点:大批量导入、批量落库这种场景,SimpleExecutor 一条一条 insert 很慢,正确做法是换 BatchExecutor、或用 MyBatis-Plus 的 saveBatch / 批量插入、甚至一次性 insert 多条。
48. MyBatis 工作流程(完整执行链路)★★★
完整链路八步:① 启动时读 mybatis 配置 + Mapper XML,解析成 Configuration(含 MappedStatement);② 拿到 SqlSessionFactory,再开 SqlSession;③ 调用 Mapper 接口方法 → MapperProxy 动态代理拦截;④ 用「接口名.方法名」定位 MappedStatement;⑤ SqlSession 交给 Executor 执行;⑥ Executor 先查一级缓存,未命中交给 StatementHandler;⑦ StatementHandler 用 ParameterHandler 设参数(#{} 预编译),执行 SQL,再用 ResultSetHandler 映射结果;⑧ 结果回填,SqlSession 关闭清一级缓存。插件 Interceptor 在 ⑤⑥⑦ 各环节可拦截。
理解链路后能串成一个体系:MyBatis-Plus 的分页插件就是拦在 Executor 这一环,把原始 SQL 包一层、拼上 LIMIT 再执行;一级缓存也是这条链路里查的,「一级缓存脏数据」「分页插件原理」都能对上。
附:原始题库(旧版逐题,与上文重叠,可折叠跳过)
展开查看原始题库
49. 什么是spring?
Spring 是个java企业级应用的开源开发框架。Spring主要用来开发Java应用,但是有些扩展是针对构建J2EE平台的web应用。Spring 框架目标是简化Java企业级应用开发,并通过POJO为基础的编程模型促进良好的编程习惯。
补充(原文详解)
Spring是一个轻量级的IoC和AOP容器框架。是为Java应用程序提供基础性服务的一套框架,目的是用于简化企业应用程序的开发,它使得开发者只需要关心业务需求。常见的配置方式有三种:基于 XML的配置、基于注解的配置、基于Java的配置。
主要由以下几个模块组成:
Spring Core:核心类库,提供IOC服务;
Spring Context:提供框架式的Bean访问方式,以及企业级功能(JNDI、定时任务等);
Spring AOP:AOP服务;
Spring DAO:对JDBC的抽象,简化了数据访问异常的处理;
Spring ORM:对现有的ORM框架的支持;
Spring Web:提供了基本的面向Web的综合特性,例如多方文件上传;
Spring MVC:提供面向Web应用的Model-View-Controller实现。
50. 你们项目中为什么使用Spring框架?
这么问的话,就直接说Spring框架的好处就可以了。比如说Spring有以下特点:
轻量:Spring 是轻量的,基本的版本大约2MB。
控制反转:Spring通过控制反转实现了松散耦合,对象们给出它们的依赖,而不是创建或查找依赖的对象们。
面向切面的编程(AOP):Spring支持面向切面的编程,并且把应用业务逻辑和系统服务分开。 容器:Spring 包含并管理应用中对象的生命周期和配置。
MVC框架:Spring的WEB框架是个精心设计的框架,是Web框架的一个很好的替代品。
事务管理:Spring 提供一个持续的事务管理接口,可以扩展到上至本地事务下至全局事务 (JTA)。
异常处理:Spring 提供方便的API把具体技术相关的异常(比如由JDBC,Hibernate or JDO抛出的)转化为一致的unchecked 异常。
51. Autowired和Resource关键字的区别?
@Resource和@Autowired都是做bean的注入时使用,其实@Resource并不是Spring的注解,它的包是javax.annotation.Resource,需要导入,但是Spring支持该注解的注入。
1、共同点
两者都可以写在字段和setter方法上。两者如果都写在字段上,那么就不需要再写setter方法。
2、不同点
( 1)@Autowired
@Autowired为Spring提供的注解,需要导入包
org.springframework.beans.factory.annotation.Autowired;只按照byType注入。
@Autowired注解是按照类型(byType)装配依赖对象,默认情况下它要求依赖对象必须存在,如果允许null值,可以设置它的required属性为false。如果我们想使用按照名称(byName)来装配,可以结合@Qualifier注解一起使用。如下:
( 2)@Resource
@Resource默认按照ByName自动注入,由J2EE提供,需要导入包javax.annotation.Resource。
@Resource有两个重要的属性: name和type,而Spring将@Resource注解的name属性解析为
bean的名字,而type属性则解析为bean的类型。所以,如果使用name属性,则使用byName的自动注入策略,而使用type属性时则使用byType自动注入策略。如果既不制定name也不制定type属性,这时将通过反射机制使用byName自动注入策略。
注:最好是将@Resource放在setter方法上,因为这样更符合面向对象的思想,通过set、get去操作属性,而不是直接去操作属性。
@Resource装配顺序:
①如果同时指定了name和type,则从Spring上下文中找到唯一匹配的bean进行装配,找不到则抛出异常。
②如果指定了name,则从上下文中查找名称(id)匹配的bean进行装配,找不到则抛出异常。
③如果指定了type,则从上下文中找到类似匹配的唯一bean进行装配,找不到或是找到多个,都会抛出异常。
④如果既没有指定name,又没有指定type,则自动按照byName方式进行装配;如果没有匹配, 则回退为一个原始类型进行匹配,如果匹配则自动装配。
@Resource的作用相当于@Autowired,只不过@Autowired按照byType自动注入。
52. 依赖注入的方式有几种,各是什么?
一、构造器注入将被依赖对象通过构造函数的参数注入给依赖对象,并且在初始化对象的时候注入。
优点: 对象初始化完成后便可获得可使用的对象。
缺点: 当需要注入的对象很多时,构造器参数列表将会很长; 不够灵活。若有多种注入方式,每种方式只需注入指定几个依赖,那么就需要提供多个重载的构造函数,麻烦。
二、 setter方法注入 IoC Service Provider通过调用成员变量提供的setter函数将被依赖对象注入给依赖类。
优点: 灵活。可以选择性地注入需要的对象。
缺点: 依赖对象初始化完成后由于尚未注入被依赖对象,因此还不能使用。
三、接口注入依赖类必须要实现指定的接口,然后实现该接口中的一个函数,该函数就是用于依赖注入。该函数的参数就是要注入的对象。
优点接口注入中,接口的名字、函数的名字都不重要,只要保证函数的参数是要注入的对象类型即可。
缺点: 侵入行太强,不建议使用。
PS:什么是侵入行? 如果类A要使用别人提供的一个功能,若为了使用这功能,需要在自己的类中增加额外的代码,这就是侵入性。
53. 说说你对Spring MVC的理解
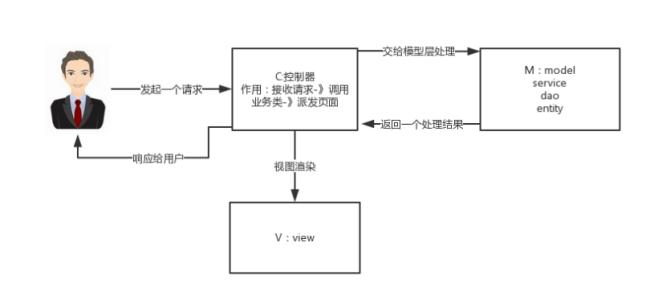
什么是MVC模式
MVC:MVC是一种设计模式
MVC的原理图:
分析:
M-Model 模型(完成业务逻辑:有javaBean构成,service+dao+entity)
V-View 视图(做界面的展示 jsp,html……)
C-Controller 控制器(接收请求—>调用模型—>根据结果派发页面)
springMVC是一个MVC的开源框架,springMVC=struts2+spring,springMVC就相当于是Struts2 加上sring的整合,但是这里有一个疑惑就是,springMVC和spring是什么样的关系呢?这个在百度百科上有一个很好的解释:意思是说,springMVC是spring的一个后续产品,其实就是spring在原有基础上,又提供了web应用的MVC模块,可以简单的把springMVC理解为是spring的一个模块
(类似AOP,IOC这样的模块),网络上经常会说springMVC和spring无缝集成,其实springMVC 就是spring的一个子模块,所以根本不需要同spring进行整合。
工作原理:
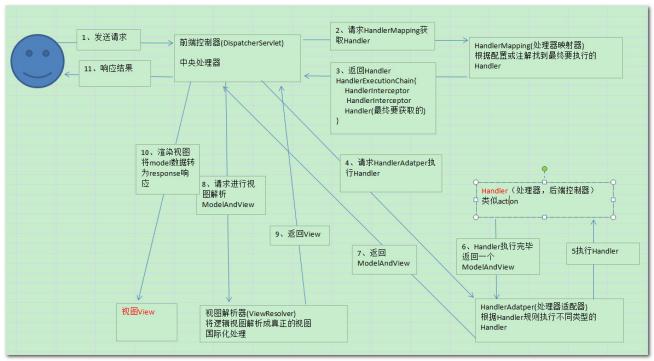
1、 用户发送请求至前端控制器DispatcherServlet。
2、 DispatcherServlet收到请求调用HandlerMapping处理器映射器。
3、 处理器映射器找到具体的处理器(可以根据xml配置、注解进行查找),生成处理器对象及处理器拦截器(如果有则生成)一并返回给DispatcherServlet。
4、 DispatcherServlet调用HandlerAdapter处理器适配器。
5、 HandlerAdapter经过适配调用具体的处理器(Controller,也叫后端控制器)。
6、 Controller执行完成返回ModelAndView。
7、 HandlerAdapter将controller执行结果ModelAndView返回给DispatcherServlet。
8、 DispatcherServlet将ModelAndView传给ViewReslover视图解析器。
9、 ViewReslover解析后返回具体View。
10、 DispatcherServlet根据View进行渲染视图(即将模型数据填充至视图中)。
11、 DispatcherServlet响应用户。
组件说明:
以下组件通常使用框架提供实现:
DispatcherServlet:作为前端控制器,整个流程控制的中心,控制其它组件执行,统一调度,降低组件之间的耦合性,提高每个组件的扩展性。
HandlerMapping:通过扩展处理器映射器实现不同的映射方式,例如:配置文件方式,实现接口方式,注解方式等。
HandlAdapter:通过扩展处理器适配器,支持更多类型的处理器。
ViewResolver:通过扩展视图解析器,支持更多类型的视图解析,例如:jsp、freemarker、 pdf、 excel等。
组件: 1、前端控制器DispatcherServlet(不需要工程师开发) ,由框架提供作用:接收请求,响应结果,相当于转发器,中央处理器。有了dispatcherServlet减少了其它组件之间的耦合度。 用户请求到达前端控制器,它就相当于mvc模式中的c,dispatcherServlet是整个流程控制的中心,由它调用其它组件处理用户的请求,dispatcherServlet的存在降低了组件之间的耦合性。
2、处理器映射器HandlerMapping(不需要工程师开发),由框架提供作用:根据请求的url查找
Handler HandlerMapping负责根据用户请求找到Handler即处理器,springmvc提供了不同的映射器实现不同的映射方式,例如:配置文件方式,实现接口方式,注解方式等。
3、处理器适配器HandlerAdapter 作用:按照特定规则(HandlerAdapter要求的规则)去执行
Handler 通过HandlerAdapter对处理器进行执行,这是适配器模式的应用,通过扩展适配器可以对更多类型的处理器进行执行。
4、处理器Handler(需要工程师开发) 注意:编写Handler时按照HandlerAdapter的要求去做, 这样适配器才可以去正确执行Handler Handler 是继DispatcherServlet前端控制器的后端控制器, 在DispatcherServlet的控制下Handler对具体的用户请求进行处理。 由于Handler涉及到具体的用户业务请求,所以一般情况需要工程师根据业务需求开发Handler。
5、视图解析器View resolver(不需要工程师开发),由框架提供作用:进行视图解析,根据逻辑视图名解析成真正的视图(view)View Resolver负责将处理结果生成View视图,View Resolver首先根据逻辑视图名解析成物理视图名即具体的页面地址,再生成View视图对象,最后对View进行渲染将
处理结果通过页面展示给用户。 springmvc框架提供了很多的View视图类型,包括:jstlView、
freemarkerView、 pdfView等。 一般情况下需要通过页面标签或页面模版技术将模型数据通过页面展示给用户,需要由工程师根据业务需求开发具体的页面。
6、视图View(需要工程师开发jsp...) View是一个接口,实现类支持不同的View类型(jsp、 freemarker、 pdf...)
核心架构的具体流程步骤如下: 1、首先用户发送请求——>DispatcherServlet,前端控制器收到请求后自己不进行处理,而是委托给其他的解析器进行处理,作为统一访问点,进行全局的流程控制; 2、 DispatcherServlet——>HandlerMapping, HandlerMapping 将会把请求映射为
HandlerExecutionChain 对象(包含一个Handler 处理器(页面控制器)对象、多个
HandlerInterceptor 拦截器)对象,通过这种策略模式,很容易添加新的映射策略; 3、
DispatcherServlet——>HandlerAdapter,HandlerAdapter 将会把处理器包装为适配器,从而支持多种类型的处理器,即适配器设计模式的应用,从而很容易支持很多类型的处理器; 4、
HandlerAdapter——>处理器功能处理方法的调用,HandlerAdapter 将会根据适配的结果调用真
正的处理器的功能处理方法,完成功能处理;并返回一个ModelAndView对象(包含模型数据、逻辑视图名); 5、 ModelAndView的逻辑视图名——> ViewResolver,ViewResolver 将把逻辑视图名解析为具体的View,通过这种策略模式,很容易更换其他视图技术; 6、View——>渲染,View 会根据传进来的Model模型数据进行渲染,此处的Model实际是一个Map数据结构,因此很容易支持其他视图技术; 7、返回控制权给DispatcherServlet,由DispatcherServlet返回响应给用户,到此一个流程结束。
看到这些步骤我相信大家很感觉非常的乱,这是正常的,但是这里主要是要大家理解springMVC中的几个组件:
前端控制器(DispatcherServlet):接收请求,响应结果,相当于电脑的CPU。
处理器映射器(HandlerMapping):根据URL去查找处理器。
处理器(Handler):需要程序员去写代码处理逻辑的。
处理器适配器(HandlerAdapter):会把处理器包装成适配器,这样就可以支持多种类型的处理器,类比笔记本的适配器(适配器模式的应用)。
视图解析器(ViewResovler):进行视图解析,多返回的字符串,进行处理,可以解析成对应的页面。
54. SpringMVC常用的注解有哪些?
@RequestMapping:用于处理请求 url 映射的注解,可用于类或方法上。用于类上,则表示类中的所有响应请求的方法都是以该地址作为父路径。
@RequestBody:注解实现接收http请求的json数据,将json转换为java对象。
@ResponseBody:注解实现将conreoller方法返回对象转化为json对象响应给客户。
55. 谈谈你对Spring的AOP理解
AOP(Aspect-Oriented Programming,面向切面编程)能够将那些与业务无关,却为业务模块所共同调用的逻辑或责任(例如事务处理、日志管理、权限控制等)封装起来,便于减少系统的重复代码,降低模块间的耦合度,并有利于未来的可扩展性和可维护性。
Spring AOP是基于动态代理的,如果要代理的对象实现了某个接口,那么Spring AOP就会使用JDK 动态代理去创建代理对象;而对于没有实现接口的对象,就无法使用JDK动态代理,转而使用CGlib 动态代理生成一个被代理对象的子类来作为代理。
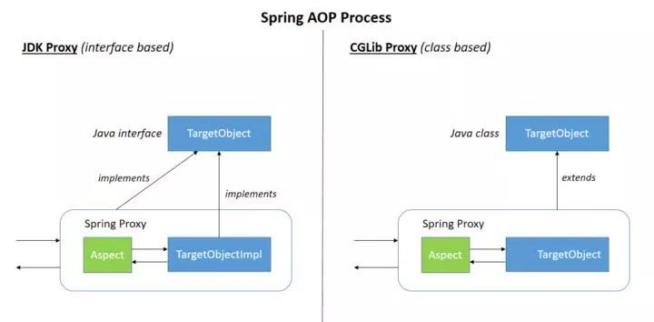
注意:图中的implements和extend。即一个是接口,一个是实现类。
当然也可以使用AspectJ,Spring AOP中已经集成了AspectJ,AspectJ应该算得上是Java生态系统中最完整的AOP框架了。使用AOP之后我们可以把一些通用功能抽象出来,在需要用到的地方直接使用即可,这样可以大大简化代码量。我们需要增加新功能也方便,提高了系统的扩展性。日志功
能、事务管理和权限管理等场景都用到了AOP。
这里只要你提到了AspectJ,那么面试官很有可能会继续问:
56. Spring AOP和AspectJ AOP有什么区别?
Spring AOP是属于运行时增强,而AspectJ是编译时增强。 Spring AOP基于代理(Proxying),而 AspectJ基于字节码操作(Bytecode Manipulation)。
Spring AOP已经集成了AspectJ,AspectJ应该算得上是Java生态系统中最完整的AOP框架了。 AspectJ相比于Spring AOP功能更加强大,但是Spring AOP相对来说更简单。
如果我们的切面比较少,那么两者性能差异不大。但是,当切面太多的话,最好选择AspectJ,它比 SpringAOP快很多。
可能还会继续问:
57. 在Spring AOP 中,关注点和横切关注的区别是什么?
关注点是应用中一个模块的行为,一个关注点可能会被定义成一个我们想实现的一个功能。 横切关注点是一个关注点,此关注点是整个应用都会使用的功能,并影响整个应用,比如日志,安全和数据传输,几乎应用的每个模块都需要的功能。因此这些都属于横切关注点。
那什么是连接点呢?连接点代表一个应用程序的某个位置,在这个位置我们可以插入一个AOP切面,它实际上是个应用程序执行Spring AOP的位置。
切入点是什么?切入点是一个或一组连接点,通知将在这些位置执行。可以通过表达式或匹配的方式指明切入点。
58. 什么是通知呢?有哪些类型呢?
通知是个在方法执行前或执行后要做的动作,实际上是程序执行时要通过SpringAOP框架触发的代码段。
Spring切面可以应用五种类型的通知:
before:前置通知,在一个方法执行前被调用。
after: 在方法执行之后调用的通知,无论方法执行是否成功。
after-returning: 仅当方法成功完成后执行的通知。
after-throwing: 在方法抛出异常退出时执行的通知。
around: 在方法执行之前和之后调用的通知。
59. 说说你对Spring的IOC是怎么理解的?
( 1)IOC就是控制反转,是指创建对象的控制权的转移。以前创建对象的主动权和时机是由自己把控的,而现在这种权力转移到Spring容器中,并由容器根据配置文件去创建实例和管理各个实例之间的依赖关系。对象与对象之间松散耦合,也利于功能的复用。 DI依赖注入,和控制反转是同一个概念的不同角度的描述,即应用程序在运行时依赖IoC容器来动态注入对象需要的外部资源。
( 2)最直观的表达就是,IOC让对象的创建不用去new了,可以由spring自动生产,使用java的反
射机制,根据配置文件在运行时动态的去创建对象以及管理对象,并调用对象的方法的。
( 3)Spring的IOC有三种注入方式:构造器注入、setter方法注入、根据注解注入。
IoC让相互协作的组件保持松散的耦合,而AOP编程允许你把遍布于应用各层的功能分离出来形成可重用的功能组件。
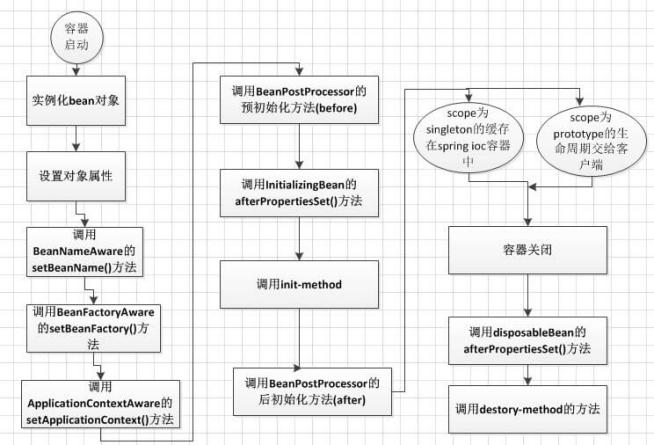
60. 解释一下spring bean的生命周期
首先说一下Servlet的生命周期:实例化,初始init,接收请求service,销毁destroy;
Spring上下文中的Bean生命周期也类似,如下:
( 1)实例化Bean:
对于BeanFactory容器,当客户向容器请求一个尚未初始化的bean时,或初始化bean的时候需要注入另一个尚未初始化的依赖时,容器就会调用createBean进行实例化。对于ApplicationContext容器,当容器启动结束后,通过获取BeanDefinition对象中的信息,实例化所有的bean。
( 2)设置对象属性(依赖注入):
实例化后的对象被封装在BeanWrapper对象中,紧接着,Spring根据BeanDefinition中的信息以及通过BeanWrapper提供的设置属性的接口完成依赖注入。
( 3)处理Aware接口:
接着,Spring会检测该对象是否实现了xxxAware接口,并将相关的xxxAware实例注入给Bean:
①如果这个Bean已经实现了BeanNameAware接口,会调用它实现的setBeanName(String beanId)方法,此处传递的就是Spring配置文件中Bean的id值;
②如果这个Bean已经实现了BeanFactoryAware接口,会调用它实现的setBeanFactory()方法,传递的是Spring工厂自身。
③如果这个Bean已经实现了ApplicationContextAware接口,会调用
setApplicationContext(ApplicationContext)方法,传入Spring上下文;
( 4)BeanPostProcessor:
如果想对Bean进行一些自定义的处理,那么可以让Bean实现了BeanPostProcessor接口,那将会调用postProcessBeforeInitialization(Object obj, Strings)方法。
( 5)InitializingBean 与 init-method:
如果Bean在Spring配置文件中配置了 init-method 属性,则会自动调用其配置的初始化方法。
( 6)如果这个Bean实现了BeanPostProcessor接口,将会调用
postProcessAfterInitialization(Object obj, Strings)方法;由于这个方法是在Bean初始化结束时调用的,所以可以被应用于内存或缓存技术;
1 以上几个步骤完成后,Bean就已经被正确创建了,之后就可以使用这个Bean了。
( 7)DisposableBean:
当Bean不再需要时,会经过清理阶段,如果Bean实现了DisposableBean这个接口,会调用其实现的destroy()方法;
( 8)destroy-method:
最后,如果这个Bean的Spring配置中配置了destroy-method属性,会自动调用其配置的销毁方法。
61. 解释Spring支持的几种bean的作用域?
Spring容器中的bean可以分为5个范围:
( 1)singleton:默认,每个容器中只有一个bean的实例,单例的模式由BeanFactory自身来维护。
( 2)prototype:为每一个bean请求提供一个实例。
( 3)request:为每一个网络请求创建一个实例,在请求完成以后,bean会失效并被垃圾回收器回收。
( 4)session:与request范围类似,确保每个session中有一个bean的实例,在session过期后, bean会随之失效。
( 5)global-session:全局作用域,global-session和Portlet应用相关。当你的应用部署在Portlet 容器中工作时,它包含很多portlet。如果你想要声明让所有的portlet共用全局的存储变量的话,那么这全局变量需要存储在global-session中。全局作用域与Servlet中的session作用域效果相同。
62. Spring基于xml注入bean的几种方式?
( 1)Set方法注入;
( 2)构造器注入:①通过index设置参数的位置;②通过type设置参数类型;
( 3)静态工厂注入;
( 4)实例工厂;
通常回答前面两种即可,因为后面两种很多人都不太会,不会的就不要说出来,不然问到你不会就尴尬了。
63. Spring框架中都用到了哪些设计模式?
这是一道相对有难度的题目,你不仅要回设计模式,还要知道每个设计模式在Spring中是如何使用的。
简单工厂模式:Spring 中的 BeanFactory 就是简单工厂模式的体现。根据传入一个唯一的标识来获得 Bean 对象,但是在传入参数后创建还是传入参数前创建,要根据具体情况来定。
工厂模式:Spring 中的 FactoryBean 就是典型的工厂方法模式,实现了 FactoryBean 接口的 bean 是一类叫做 factory 的 bean。其特点是,spring 在使用 getBean() 调用获得该 bean 时,会自动调用该 bean 的 getObject() 方法,所以返回的不是 factory 这个 bean,而是这个 bean.getOjbect() 方法的返回值。
单例模式:在 spring 中用到的单例模式有: scope="singleton",注册式单例模式,bean 存放于 Map 中。bean name 当做 key,bean 当做 value。
原型模式:在 spring 中用到的原型模式有: scope="prototype",每次获取的是通过克隆生成的新实例,对其进行修改时对原有实例对象不造成任何影响。
迭代器模式:在 Spring 中有个 CompositeIterator 实现了 Iterator,Iterable 接口和 Iterator 接口,这两个都是迭代相关的接口。可以这么认为,实现了 Iterable 接口,则表示某个对象是可被迭代的。 Iterator 接口相当于是一个迭代器,实现了 Iterator 接口,等于具体定义了这个可被迭代的对象时如何进行迭代的。
代理模式:Spring 中经典的 AOP,就是使用动态代理实现的,分 JDK 和 CGlib 动态代理。
适配器模式:Spring 中的 AOP 中 AdvisorAdapter 类,它有三个实现:
MethodBeforAdviceAdapter、AfterReturnningAdviceAdapter、ThrowsAdviceAdapter。Spring 会根据不同的 AOP 配置来使用对应的 Advice,与策略模式不同的是,一个方法可以同时拥有多个 Advice。Spring 存在很多以 Adapter 结尾的,大多数都是适配器模式。
观察者模式:Spring 中的 Event 和 Listener。spring 事件:ApplicationEvent,该抽象类继承了 EventObject 类,JDK 建议所有的事件都应该继承自 EventObject。spring 事件监听器:
ApplicationListener,该接口继承了 EventListener 接口,JDK 建议所有的事件监听器都应该继承 EventListener。
模板模式:Spring 中的 org.springframework.jdbc.core.JdbcTemplate 就是非常经典的模板模式的应用,里面的 execute 方法,把整个算法步骤都定义好了。
责任链模式:DispatcherServlet 中的 doDispatch() 方法中获取与请求匹配的处理器 HandlerExecutionChain,this.getHandler() 方法的处理使用到了责任链模式。
注意:这里只是列举了部分设计模式,其实里面用到了还有享元模式、建造者模式等。可选择性的回答,主要是怕你回答了迭代器模式,然后继续问你,结果你一问三不知,那就尴了尬了。
64. Spring 框架中的单例 Bean 是线程安全的么?
Spring 框架并没有对单例 Bean 进行任何多线程的封装处理。
关于单例 Bean 的线程安全和并发问题,需要开发者自行去搞定。
单例的线程安全问题,并不是 Spring 应该去关心的。 Spring 应该做的是,提供根据配置,创建单例 Bean 或多例 Bean 的功能。
当然,但实际上,大部分的 Spring Bean 并没有可变的状态,所以在某种程度上说 Spring 的单例 Bean 是线程安全的。如果你的 Bean 有多种状态的话,就需要自行保证线程安全。最浅显的解决办
法,就是将多态 Bean 的作用域(Scope)由 Singleton 变更为 Prototype。
65. Spring 是怎么解决循环依赖的?
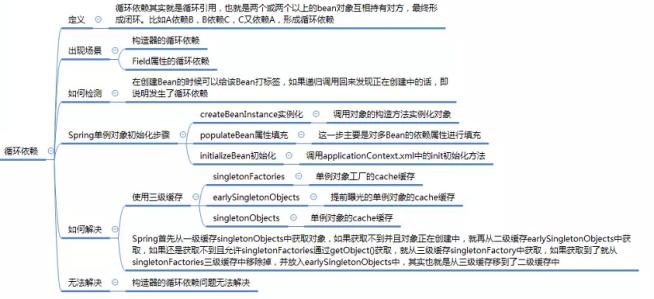
整个流程大致如下:
首先 A 完成初始化第一步并将自己提前曝光出来(通过 ObjectFactory 将自己提前曝光),在 初始化的时候,发现自己依赖对象 B,此时就会去尝试 get(B),这个时候发现 B 还没有被创建 出来;
然后 B 就走创建流程,在 B 初始化的时候,同样发现自己依赖 C ,C 也没有被创建出来;
这个时候 C 又开始初始化进程,但是在初始化的过程中发现自己依赖 A,于是尝试 get(A)。这 个时候由于 A 已经添加至缓存中(一般都是添加至三级缓存 singletonFactories),通过
ObjectFactory 提前曝光,所以可以通过 ObjectFactory#getObject() 方法来拿到 A 对象。 C 拿到 A 对象后顺利完成初始化,然后将自己添加到一级缓存中;
- 回到 B ,B 也可以拿到 C 对象,完成初始化,A 可以顺利拿到 B 完成初始化。到这里整个链路 就已经完成了初始化过程了。
关键字:三级缓存,提前曝光。
66. 说说事务的隔离级别
未提交读(Read Uncommitted):允许脏读,也就是可能读取到其他会话中未提交事务修改的数据
提交读(Read Committed):只能读取到已经提交的数据。 Oracle等多数数据库默认都是该级别 (不重复读)
可重复读(Repeated Read):在同一个事务内的查询都是事务开始时刻一致的,Mysql的InnoDB默认级别。在SQL标准中,该隔离级别消除了不可重复读,但是还存在幻读(多个事务同时修改同一条记录,事务之间不知道彼此存在,当事务提交之后,后面的事务修改的数据将会覆盖前事务,前一个事务就像发生幻觉一样)
可串行化(Serializable):完全串行化的读,每次读都需要获得表级共享锁,读写相互都会阻塞。
不可重复读和幻读的区别主要是:解决不可重复读需要锁定了当前满足条件的记录,而解决幻读需要锁定当前满足条件的记录及相近的记录。比如查询某个商品的信息,可重复读事务隔离级别可以保证当前商品信息被锁定,解决不可重复读;但是如果统计商品个数,中途有记录插入,可重复读事务隔离级别就不能保证两个事务统计的个数相同。
67. 说说事务的传播级别
Spring事务定义了7种传播机制:
PROPAGATION_REQUIRED:默认的Spring事物传播级别,若当前存在事务,则加入该事务,若 不存在事务,则新建一个事务。
PAOPAGATION_REQUIRE_NEW:若当前没有事务,则新建一个事务。若当前存在事务,则新建 一个事务,新老事务相互独立。外部事务抛出异常回滚不会影响内部事务的正常提交。
PROPAGATION_NESTED:如果当前存在事务,则嵌套在当前事务中执行。如果当前没有事务, 则新建一个事务,类似于REQUIRE_NEW。
PROPAGATION_SUPPORTS:支持当前事务,若当前不存在事务,以非事务的方式执行。
PROPAGATION_NOT_SUPPORTED:以非事务的方式执行,若当前存在事务,则把当前事务挂 起。
PROPAGATION_MANDATORY:强制事务执行,若当前不存在事务,则抛出异常. 7. PROPAGATION_NEVER:以非事务的方式执行,如果当前存在事务,则抛出异常。
Spring事务传播级别一般不需要定义,默认就是PROPAGATION_REQUIRED,除非在嵌套事务的情况下需要重点了解。
68. Spring 事务实现方式
编程式事务管理:这意味着你可以通过编程的方式管理事务,这种方式带来了很大的灵活性,但很难维护。
声明式事务管理:这种方式意味着你可以将事务管理和业务代码分离。你只需要通过注解或者XML 配置管理事务。
69. 事务三要素是什么?
数据源:表示具体的事务性资源,是事务的真正处理者,如MySQL等。
事务管理器:像一个大管家,从整体上管理事务的处理过程,如打开、提交、回滚等。
事务应用和属性配置:像一个标识符,表明哪些方法要参与事务,如何参与事务,以及一些相关属性如隔离级别、超时时间等。
70. 事务注解的本质是什么?
@Transactional 这个注解仅仅是一些(和事务相关的)元数据,在运行时被事务基础设施读取消费,并使用这些元数据来配置bean的事务行为。 大致来说具有两方面功能, 一是表明该方法要参与事务,二是配置相关属性来定制事务的参与方式和运行行为
声明式事务主要是得益于Spring AOP。使用一个事务拦截器,在方法调用的前后/周围进行事务性增强(advice),来驱动事务完成。
@Transactional注解既可以标注在类上,也可以标注在方法上。当在类上时,默认应用到类里的所有方法。如果此时方法上也标注了,则方法上的优先级高。 另外注意方法一定要是public的。
71. 当实体类中的属性名和表中的字段名不一样,怎么办?
第1种: 通过在查询的sql语句中定义字段名的别名,让字段名的别名和实体类的属性名一致。
第2种: 通过来映射字段名和实体类属性名的一一对应的关系。
72. Mybatis是如何进行分页的?分页插件的原理是什么?
Mybatis使用RowBounds对象进行分页,它是针对ResultSet结果集执行的内存分页,而非物理分页。可以在sql内直接拼写带有物理分页的参数来完成物理分页功能,也可以使用分页插件来完成物理分页,比如:MySQL数据的时候,在原有SQL后面拼写limit。
分页插件的基本原理是使用Mybatis提供的插件接口,实现自定义插件,在插件的拦截方法内拦截待执行的sql,然后重写sql,根据dialect方言,添加对应的物理分页语句和物理分页参数。
73. Mybatis是如何将sql执行结果封装为目标对象并返回的?都有哪些映射形式?
第一种是使用标签,逐一定义数据库列名和对象属性名之间的映射关系。
第二种是使用sql列的别名功能,将列的别名书写为对象属性名。
有了列名与属性名的映射关系后,Mybatis通过反射创建对象,同时使用反射给对象的属性逐一赋值并返回,那些找不到映射关系的属性,是无法完成赋值的。
74. 如何执行批量插入?
首先,创建一个简单的insert语句:
然后在java代码中像下面这样执行批处理插入:list<string> names = new arraylist();names.add(“fred”);names.add(“barney”);names.add(“betty”);names.add(“wilma”);// 注意这里 executortype.batchsqlsession sqlsession = sqlsessionfactory.opensession(executortype.batch); try {namemapper mapper = sqlsession.getmapper(namemapper.class);for (string name : names) {mapper.insertname(name);}sqlsession.commit();}catch(Exception e){e.printStackTrace();sqlSession.rollback();throw e;}finally
75. Xml映射文件中,除了常见的select|insert|updae|delete 标签之外,还有哪些标签?
加上动态sql的9个标签,其中为sql片段标签,通过标签引入sql片段,为不支持自增的主键生成策略标签。
76. MyBatis实现一对一有几种方式?具体怎么操作的?
有联合查询和嵌套查询,联合查询是几个表联合查询,只查询一次, 通过在resultMap里面配置 association节点配置一对一的类就可以完成;
嵌套查询是先查一个表,根据这个表里面的结果的外键id,去再另外一个表里面查询数据,也是通过 association配置,但另外一个表的查询通过select属性配置。
77. Mybatis是否支持延迟加载?如果支持,它的实现原理是什么?
Mybatis仅支持association关联对象和collection关联集合对象的延迟加载,association指的就是一
对一,collection指的就是一对多查询。在Mybatis配置文件中,可以配置是否启用延迟加载 lazyLoadingEnabled=true|false。
它的原理是,使用CGLIB创建目标对象的代理对象,当调用目标方法时,进入拦截器方法,比如调用a.getB().getName(),拦截器invoke()方法发现a.getB()是null值,那么就会单独发送事先保存好的
查询关联B对象的sql,把B查询上来,然后调用a.setB(b),于是a的对象b属性就有值了,接着完成 a.getB().getName()方法的调用。这就是延迟加载的基本原理。
当然了,不光是Mybatis,几乎所有的包括Hibernate,支持延迟加载的原理都是一样的。
78. 说说Mybatis的缓存机制:
Mybatis整体:
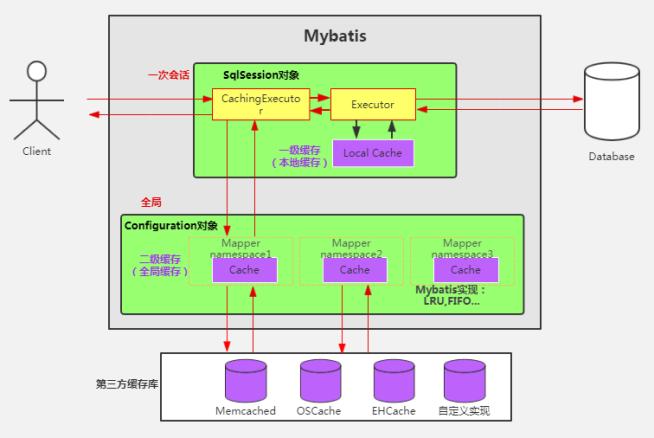
一级缓存localCache
在应用运行过程中,我们有可能在一次数据库会话中,执行多次查询条件完全相同的 SQL,
MyBatis 提供了一级缓存的方案优化这部分场景,如果是相同的 SQL 语句,会优先命中一级缓存, 避免直接对数据库进行查询,提高性能。
每个 SqlSession 中持有了 Executor,每个 Executor 中有一个 LocalCache。当用户发起查询时, MyBatis 根据当前执行的语句生成 MappedStatement,在 Local Cache 进行查询,如果缓存命中的话,直接返回结果给用户,如果缓存没有命中的话,查询数据库,结果写入 Local Cache,最后返回结果给用户。具体实现类的类关系图如下图所示:
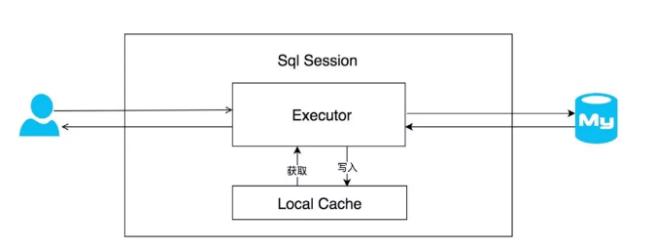
MyBatis 一级缓存的生命周期和 SqlSession 一致。
MyBatis 一级缓存内部设计简单,只是一个没有容量限定的 HashMap,在缓存的功能性上有 所欠缺。
MyBatis 的一级缓存最大范围是 SqlSession 内部,有多个 SqlSession 或者分布式的环境下, 数据库写操作会引起脏数据,建议设定缓存级别为 Statement。
二级缓存
在上文中提到的一级缓存中,其最大的共享范围就是一个 SqlSession 内部,如果多个 SqlSession 之间需要共享缓存,则需要使用到二级缓存。开启二级缓存后,会使用 CachingExecutor 装饰
Executor,进入一级缓存的查询流程前,先在 CachingExecutor 进行二级缓存的查询,具体的工作流程如下所示。
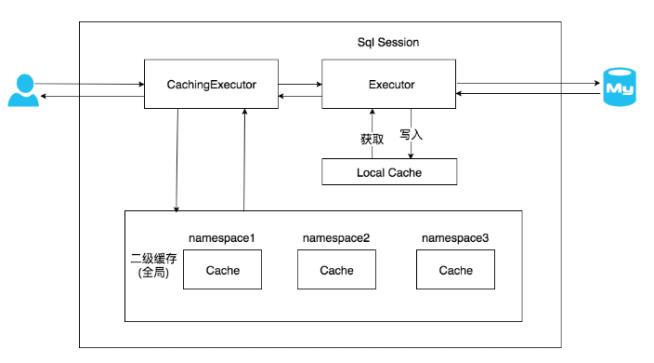
二级缓存开启后,同一个 namespace 下的所有操作语句,都影响着同一个 Cache,即二级缓存被多个 SqlSession 共享,是一个全局的变量。
当开启缓存后,数据的查询执行的流程为:
二级缓存 -> 一级缓存 -> 数据库
MyBatis 的二级缓存相对于一级缓存来说,实现了 SqlSession 之间缓存数据的共享,同时粒度 更加细,能够到 namespace 级别,通过 Cache 接口实现类不同的组合,对 Cache 的可控性 也更强。
MyBatis 在多表查询时,极大可能会出现脏数据,有设计上的缺陷,安全使用二级缓存的条件 比较苛刻。
在分布式环境下,由于默认的 MyBatis Cache 实现都是基于本地的,分布式环境下必然会出现 读取到脏数据,需要使用集中式缓存将 MyBatis 的 Cache 接口实现,有一定的开发成本,直 接使用 Redis、 Memcached 等分布式缓存可能成本更低,安全性也更高。
79. JDBC 编程有哪些步骤?
1.装载相应的数据库的 JDBC 驱动并进行初始化:
2.建立 JDBC 和数据库之间的 Connection 连接:
3.创建 Statement 或者 PreparedStatement 接口,执行 SQL 语句。
4.处理和显示结果。
5.释放资源。
80. MyBatis 中见过什么设计模式?
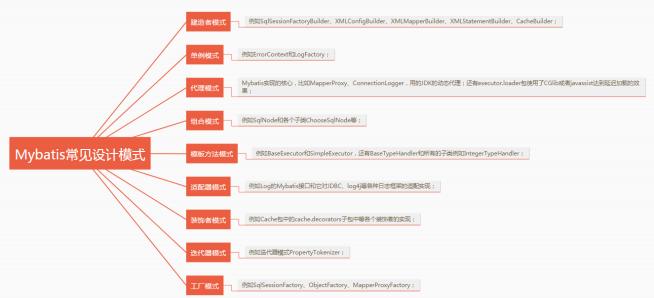
81. MyBatis 中比如 UserMapper.java 是接口,为什么没有实现类还能调用?
使用JDK动态代理+MapperProxy。本质上调用的是MapperProxy的invoke方法。
1 欢迎关注微信公众号:Java后端技术全栈
82. Spring Boot 的核心注解是哪个?它主要由哪几个注解组成
的?
启动类上面的注解是@SpringBootApplication,它也是 Spring Boot 的核心注解,主要组合包含了以下 3 个注解:
@SpringBootConfiguration:组合了 @Configuration 注解,实现配置文件的功能。
@EnableAutoConfiguration:打开自动配置的功能,也可以关闭某个自动配置的选项,如关闭数据源自动配置功能: @SpringBootApplication(exclude = { DataSourceAutoConfiguration.class })。
@ComponentScan:Spring组件扫描。
83. 运行Spring Boot有哪几种方式?
1)打包用命令或者放到容器中运行
2)用 Maven/Gradle 插件运行
3)直接执行 main 方法运行
补充(原文详解)
主要有两种方式:
Spring Loaded
Spring-boot-devtools
84. 如何理解 Spring Boot 中的 Starters?
Starters是什么:
Starters可以理解为启动器,它包含了一系列可以集成到应用里面的依赖包,你可以一站式集成
Spring及其他技术,而不需要到处找示例代码和依赖包。如你想使用Spring JPA访问数据库,只要加入spring-boot-starter-data-jpa启动器依赖就能使用了。Starters包含了许多项目中需要用到的依赖,它们能快速持续的运行,都是一系列得到支持的管理传递性依赖。
Starters命名:
Spring Boot官方的启动器都是以spring-boot-starter-命名的,代表了一个特定的应用类型。第三方的启动器不能以spring-boot开头命名,它们都被Spring Boot官方保留。一般一个第三方的应该这样命名,像mybatis的mybatis-spring-boot-starter。
Starters分类:
- Spring Boot应用类启动器
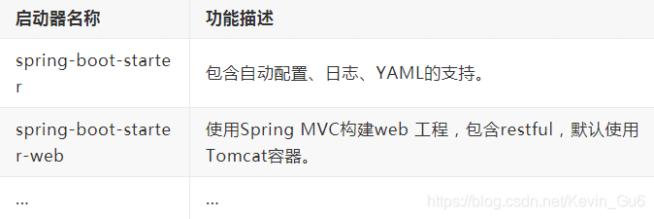
Spring Boot生产启动器
Spring Boot技术类启动器
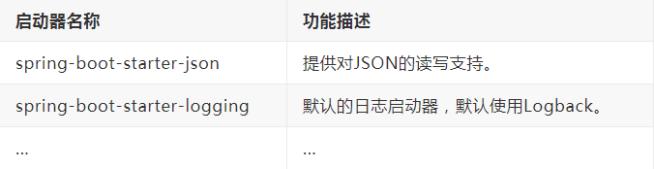
- 其他第三方启动器
补充(原文详解)
Starters可以理解为启动器,它包含了一系列可以集成到应用里面的依赖包,你可以一站式集成
Spring 及其他技术,而不需要到处找示例代码和依赖包。如你想使用 Spring JPA 访问数据库,只要加入 spring-boot-starter-data-jpa 启动器依赖就能使用了。
补充(原文详解)
spring-boot-starter-web 嵌入tomcat和web开发需要servlet与jsp支持
spring-boot-starter-data-jpa 数据库支持
spring-boot-starter-data-redis redis数据库支持
spring-boot-starter-data-solr solr支持
mybatis-spring-boot-starter 第三方的mybatis集成starter
85. 如何在Spring Boot启动的时候运行一些特定的代码?
如果你想在Spring Boot启动的时候运行一些特定的代码,你可以实现接口ApplicationRunner或者CommandLineRunner,这两个接口实现方式一样,它们都只提供了一个run方法。
CommandLineRunner:启动获取命令行参数
86. Spring Boot 需要独立的容器运行吗?
可以不需要,内置了 Tomcat/ Jetty 等容器。
87. Spring Boot中的监视器是什么?
Spring boot actuator是spring启动框架中的重要功能之一。Spring boot监视器可帮助您访问生产环境中正在运行的应用程序的当前状态。有几个指标必须在生产环境中进行检查和监控。即使一些外部应用程序可能正在使用这些服务来向相关人员触发警报消息。监视器模块公开了一组可直接作为HTTP URL访问的REST端点来检查状态。
88. 如何使用Spring Boot实现异常处理?
Spring提供了一种使用ControllerAdvice处理异常的非常有用的方法。 我们通过实现一个 ControlerAdvice类,来处理控制器类抛出的所有异常。
89. 如何理解 Spring Boot 配置加载顺序?
在 Spring Boot 里面,可以使用以下几种方式来加载配置。
1)properties文件;
2)YAML文件;
3)系统环境变量;
4)命令行参数;
等等 ……
90. Spring Boot 的核心配置文件有哪几个?它们的区别是什么?
pring Boot 的核心配置文件是 application 和 bootstrap 配置文件。
application 配置文件这个容易理解,主要用于 Spring Boot 项目的自动化配置。
bootstrap 配置文件有以下几个应用场景。
使用 Spring Cloud Config 配置中心时,这时需要在 bootstrap 配置文件中添加连接到配置中心的配置属性来加载外部配置中心的配置信息;
一些固定的不能被覆盖的属性;
一些加密/解密的场景;
91. 如何集成 Spring Boot 和 ActiveMQ?
对于集成 Spring Boot 和 ActiveMQ,我们使用 spring-boot-starter-activemq 依赖关系。 它只需要很少的配置,并且不需要样板代码。
附:一句话速记(可以跳过 ★☆☆)
- Spring Test:
@SpringBootTest起容器、@MockBean打桩,写集成测试用。 @ControllerAdvice与@RestControllerAdvice:后者是前者的 ResponseBody 版本,返回 JSON 用它。